-
[가상면접 사례로 배우는 대규모 시스템 설계 기초] 1장. 사용자 수에 따른 규모 확장성📕 book/가상 면접 사례로 배우는 대규모 시스템 설계 기초 2025. 12. 25. 12:57
이번 장에서는 한 명의 사용자를 지원하는 시스템에서 몇백만 사용자를 지원하는 시스템을 설계하는 과정에서 규모 확장성과 관계된 설계 문제를 푸는데 필요한 지식들을 학습을 해볼 수 있다.
📌 단일 서버
웹, 앱, 데이터베이스, 캐시 등이 전부 서버 한 대에서 실행
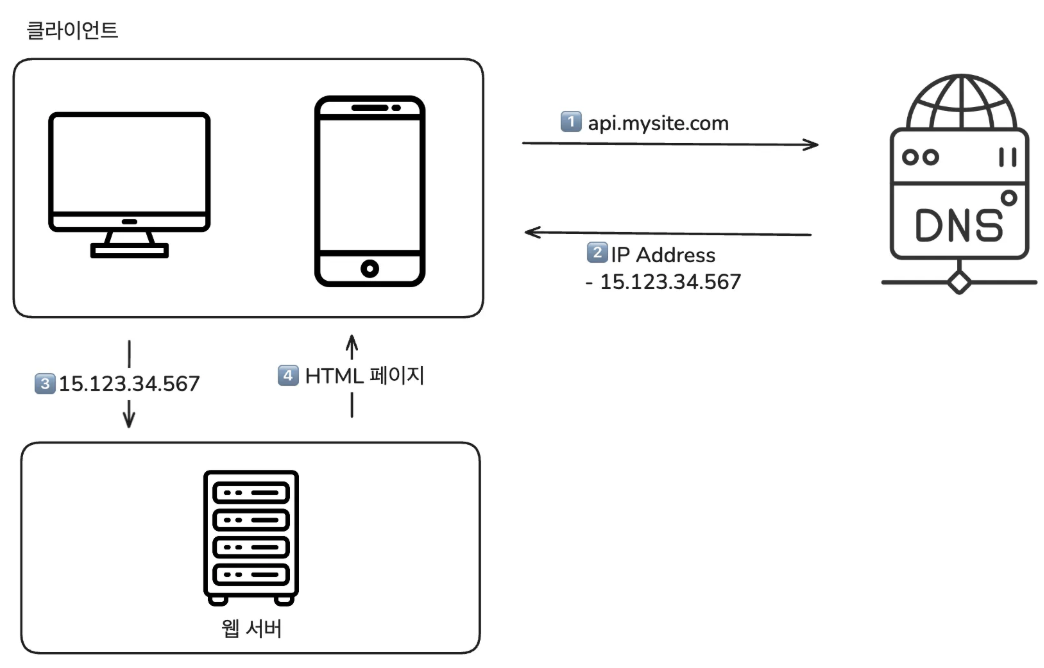
📦 데이터베이스
사용자가 늘면 서버 하나로는 충분하지 않기 때문에 여러 서버를 두어야 한다.
- 웹 / 모바일 트래픽 처리 용도
- 데이터 베이스 용
💡 웹 / 모바일 트래픽 처리 서버(웹 계층) 와 데이터베이스 서버(데이터 계층) 을 분리하면 각각을 독립적으로 확장해 나갈 수 있게 된다.
↗️ 수직적 규모 확장 vs 수평적 규모 확장
🔼 수직적 규모 확장 (scale up)
- 서버에 고사양 자원을 추가하는 행위
🔀 수평적 규모 확장 (scale out)
- 더 많은 서버를 추가하여 성능을 개선하는 행위
서버로 유입되는 트래픽의 양이 적을 때는 수직적 확장이 좋은 선택!
- 이 방법의 가장 큰 장점은 단순함.
⚠️ 그러나 스케일 업에는 몇 가지 심각한 단점이 있다.
- 한계: 한 대의 서버에 CPU나 메모리를 무한대로 증성할 방법은 없다.
- 장애에 대한 자동복구(failover) 방안이나 다중화 방안을 제시하지 않는다.
- 서버에 장애가 발생하면 웹사이트 / 앱은 완전히 중단된다.
💡 따라서 대규모 애플리케이션을 지원하는 데는 수평적 규모 확장법이 보다 적절하다
⏩ 로드밸런서
부하 분산 집합에 속한 웹 서버들에게 트래픽 부하를 고르게 분산하는 역할
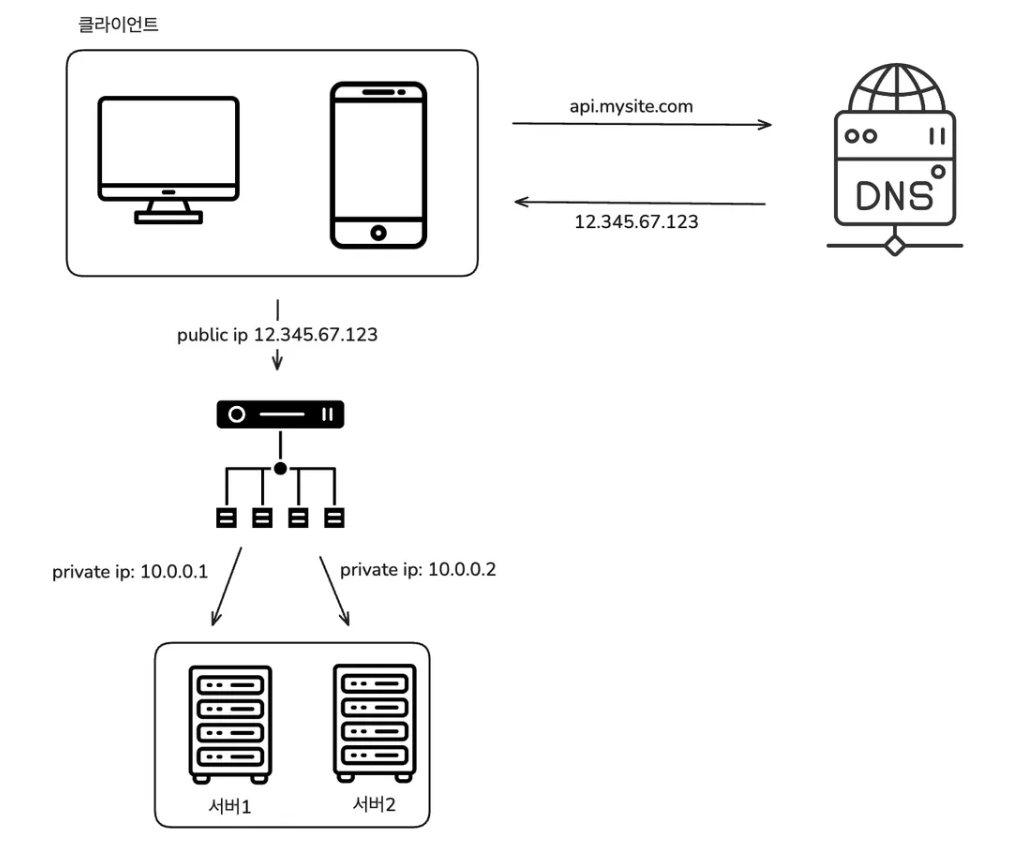
사용자는 로드밸런서의 public IP address로 접속
서버 간 통신에는 private IP address를 이용
📖 private IP address
같은 네트워크에 속한 서버 사이의 통신에만 쓰일 수 있는 IP 주소
- 로드밸런서는 웹 서버와 통신하기 위해 이 사설 주소를 이용
부하 분산 집합에 웹 서버를 추가하고 나면(scale out) 장애를 자동복구하지 못하는 문제 (no failover)가 해소되고 웹 계층의 가용성(availability)는 향상된다.
📖 failover
- 어떤 서버가 죽으면 다른 서버가 자동으로 그 역할을 대신하게 바뀌는 것
📖 웹 계층의 가용성
- 사용자가 웹 서비스를 쓰고 싶을 때 웹 서버가 정상 동작 중이라서 요청을 처리해 줄 확률, 비율
- 웹 애플리케이션이 작동하는 시간의 비율
📦 데이터베이스 다중화
로드밸런서를 웹 계층에 적용하여 트래픽을 분산하고 장애의 자동복구나 다중화를 지원하게 되었는데 데이터베이스 서버는 하나뿐이다.
많은 데이터베이스 관리 시스템은 다중화를 지원한다.
🎭 master-slave
보통은 서버 사이에 master-slave 관계를 설정
- 데이터 원본은 주 서버에 사본은 부 서버에 저장하는 방식
쓰기 연산은 마스터에서만 지원하고 부 데이터베이스는 주 데이터베이스로부터 그 사본을 전달받아 읽기 연산만을 지원한다.
대부분의 애플리케이션은 읽기 연산의 비중이 쓰기 연산보다 훨씬 높다.
따라서 부 데이터베이스의 수가 주 데이터베이스의 수보다 많다.
👍 좋은 점
- 더 나은 성능: 모든 데이터 변경 연산은 주 데이터베이스 서버로, 읽기 연산은 부 데이터베이스 서버들로 분산되어 병렬로 처리될 수 있는 query 수가 늘어나 성능이 좋아진다.
- 안정성: 데이터베이스 서버중 일부가 파괴되어도 데이터는 보존된다.
- 가용성: 데이터를 여러 지역에 복제해 둠으로써 하나의 데이터 베이스 서버에 장애가 발생하더라도 다른 서버의 데이터를 가져올 수 있다.
⬅️ 캐시
응답 시간은 캐시를 붙이고 정적 콘텐츠를 콘텐츠 전송 네트워크(Content Delivery Network, CDN) 로 옮기면 개선할 수 있다.
캐시는 값 비싼 연산 결과 또는 자주 참조되는 데이터를 메모리 안에 두고 뒤이은 요청이 보다 빨리 처리될 수 있도록 하는 저장소이다.
애플리케이션의 성능은 데이터베이스를 얼마나 자주 호출하느냐에 크게 좌우되는데 캐시는 그런 문제를 완화할 수 있다.
✔️ 캐시 계층
캐시 계층은 데이터가 잠시 보관되는 곳으로 데이터베이스보다 훨씬 빠르다.
- 성능이 개선될 뿐아니라 데이터베이스의 부하를 줄일 수 있다.
🤖 캐시 우선 읽기 전략
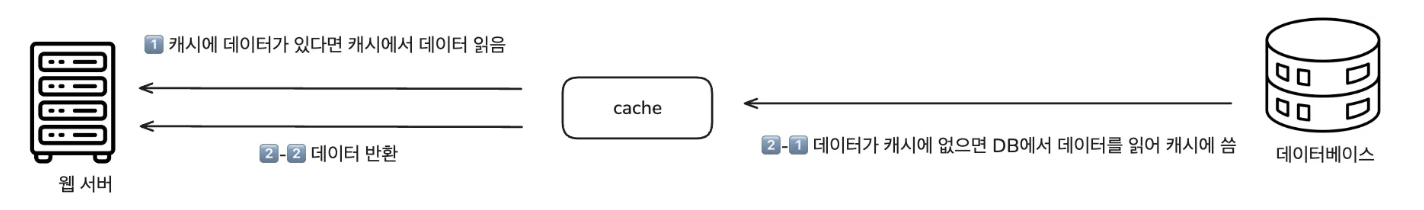
- 요청을 받은 웹 서버는 캐시에 응답이 저장되어 있는지를 확인 후 저장이 되어 있다면 클라이언트에 반환
- 없는 경우 데이터베이스에서 데이터를 찾아 캐시에 저장한 뒤 클라이언트에 반환
⚠️ 캐시 사용시 유의할 점
🔍 캐시는 어떤 상황에 바람직한가?
- 데이터 갱신은 자주 일어나지 않지만 참조는 빈번하게 일어나는 경우 고려해볼 만하다.
🔍 어떤 데이터를 캐시에 두어야 하나?
- 영속적으로 보관할 데이터를 캐시에 두는 것은 바람직하지 않다.
- 중요한 데이터는 지속적 저장소에 두어야 한다.
🔍 캐시에 보관된 데이터는 어떻게 만료되는가?
- 이에 대한 정책을 마련해 두는 것은 좋다.
- 만료 정책이 없으면 데이터는 캐시에 계속 남게 된다.
🔍 일관성은 어떻게 유지되는가?
- 데이터 저장소의 원본과 캐시 내의 사본이 같은지 여부
- 저장소의 원본을 갱신하는 연산과 캐시를 갱신하는 연산이 단일 트랜잭션으로 처리되지 않는 경우 이 일관성은 깨질 수 있다.
🔍 장애에는 어떻게 대응?
- 캐시 서버를 한 대만 두는 경우 해당 서버는 단일 장애 지점(Single Point of Failure, SPOF)이 되어버릴 가능성이 있다.
- SPOF를 피하기 위해서는 캐시 서버를 분산시켜야 한다.
🔍 캐시 메모리는 얼마나 크게 잡을 것인가?
- 캐시 메모리가 너무 작으면 데이터가 너무 자주 캐시에서 밀려나 성능이 떨어진다.
- 캐시 메모리를 과할당하면 보관될 데이터가 갑자기 늘어났을 때 생길 문제도 방지할 수 있게 된다.
🔍 데이터 방출 정책은 무엇인가?
- 캐시가 꽉 차면 추가로 캐시에 데이터를 넣어야 할 경우 기존 데이터를 내보내야 한다.
- 가장 널리 쓰이는 것은 LRU 이다
- Least Recently Used
- 마지막으로 사용된 시점이 가장 오래된 데이터를 내보내는 정책
🌐 콘텐츠 전송 네트워크 (CDN)
CDN은 정적 콘텐츠를 전송하는데 쓰이는 지리적으로 분산된 서버의 네트워크이다.
- 이미지, 비디오, CSS, Javascript 파일등을 캐시할 수 있다.
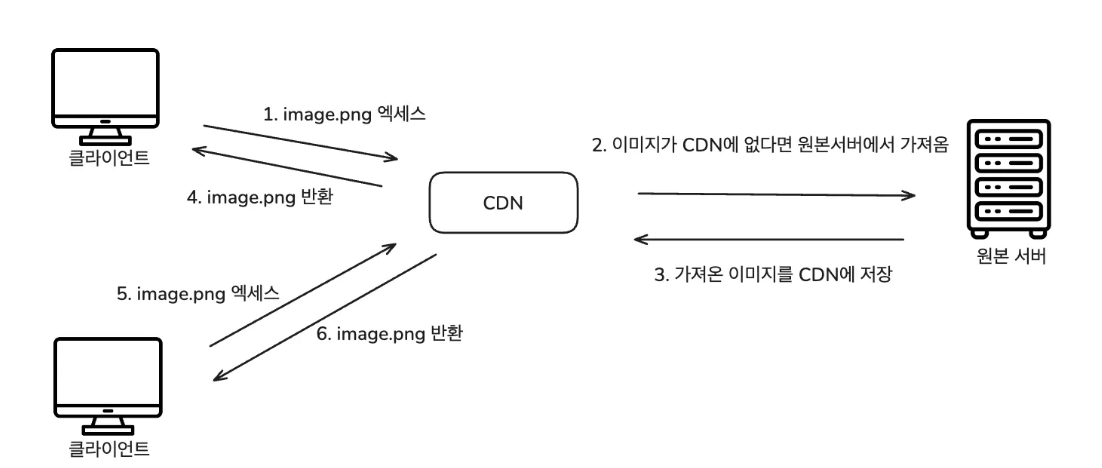
- 사용자 A가 이미지 URL을 이용해 image.png에 접근한다.
- CDN 서버의 캐시에 해당 이미지가 없는 경우, 서버는 원본 서버에 요청하여 파일을 가져온다.
- 원본 서버는 웹 서버일 수도 아마존 S3 같은 온라인 저장소일 수도 있다.
- 원본 서버가 파일을 CDN 서버에 반환한다.
- TTL 값을 응답 HTTP 헤더로 전달
- CDN 서버는 파일을 캐시하고 사용자 A에게 반환한다.
- TTL에 명시된 시간이 끝날 때 까지 캐시
- 사용자 B가 같은 이미지에 대한 요청을 CDN 서버에 전송한다.
- 만료되지 않은 이미지에 대한 요청은 캐시를 통해 처리된다.
🖥️ 무상태 웹 계층(stateless)
이제 웹 계층을 수평적으로 확장하는 방법을 고민해보자.
상태 정보(사용자 세션 데이터 등)을 웹 계층에서 제거하고 관계형 데이터베이스나 NoSQL 같은 지속성 저장소에 보관하고 필요할 때 가져오도록 한다.
- 이렇게 구성된 웹 계층을 무상태 웹 계층이라 한다.
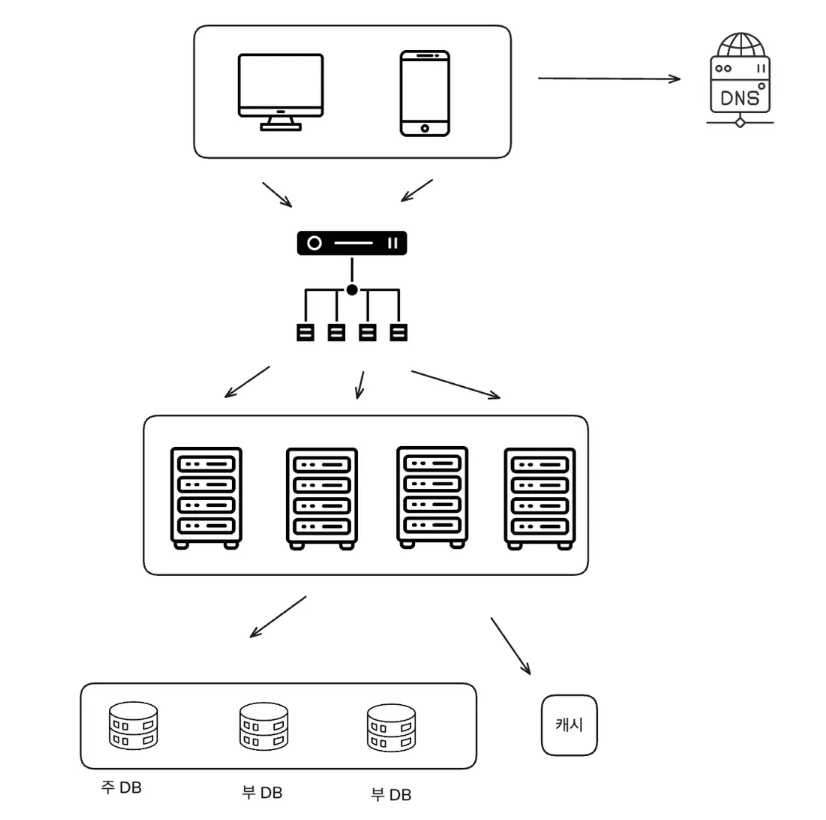
사용자의 HTTP 요청은 어떤 웹 서버로 전달될 수 있고 웹 서버는 상태 정보가 필요할 경우 공유 저장소에서 데이터를 가져온다.
- 상태 정보는 웹 서버로부터 분리되어 있어 단순하고 안정적이며 규모 확장이 쉽다.
🏬 데이터 센터
장애가 없는 상황에서 사용자는 가장 가까운 데이터 센터로 안내되는데 이 절차를 지리적 라우팅이라 부른다.
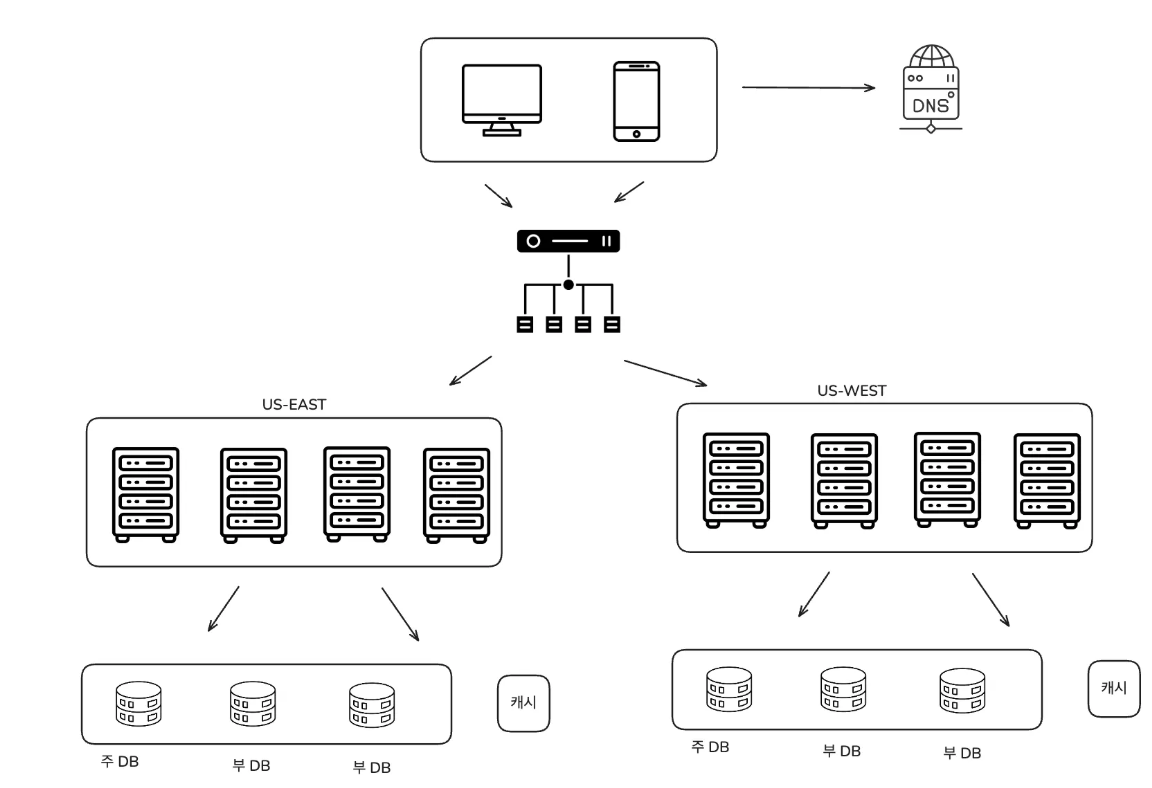
데이터 센터중에 하나에 장애가 발생하면 모든 트래픽은 장애가 없는 데이터 센터로 전송된다.
💡 다중 데이터센터 아키텍처를 위한 기술적 난제 해결
1️⃣ 트래픽 우회
올바른 데이터 센터로 트래픽을 보내는 효과적인 방법을 찾기
- GeoDNS는 사용자에게서 가장 가까운 데이터센터로 트래픽을 보낼 수 있도록 해준다.
2️⃣ 데이터 동기화
- 데이터 센터마다 별도의 DB를 사용한다면 다른 데이터센터에서는 찾는 데이터가 없을 수 있다.
3️⃣ 테스트와 배포
- 웹 사이트 애플리케이션을 여러 위치에서 테스트 해보는 것이 좋다.
📬 메시지 큐
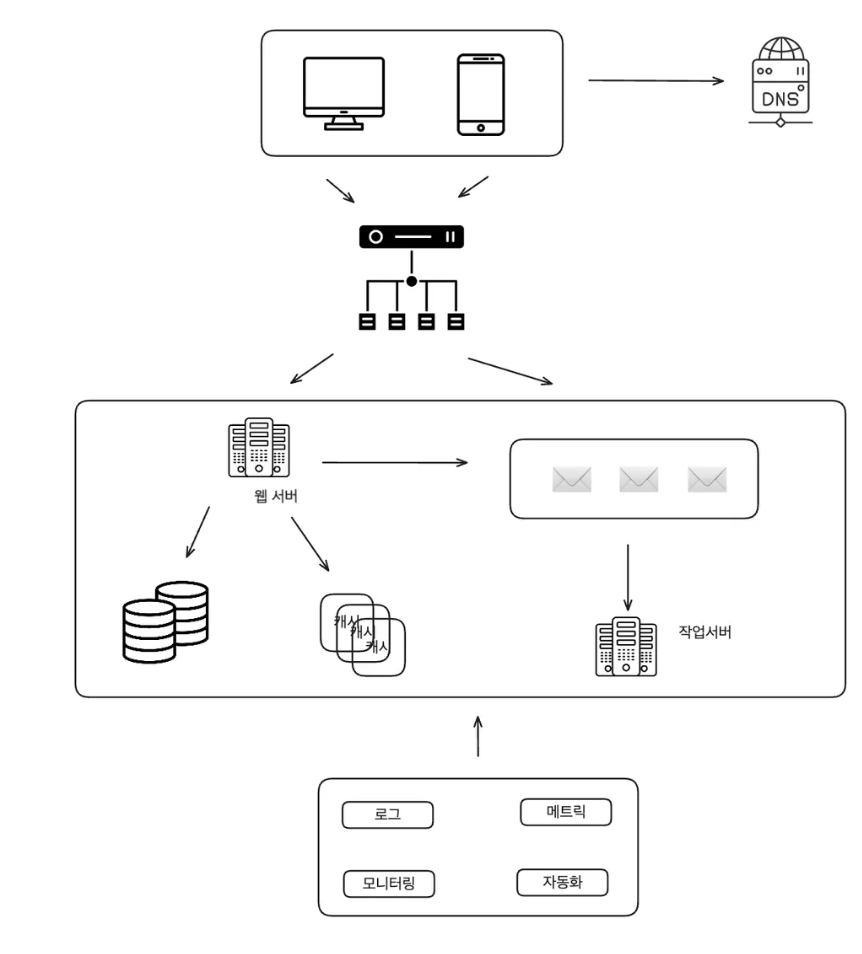
메시지 큐는 메시지의 무손실을 보장하는 메시지의 버퍼 역할을 비동기적으로 한다.
Publish / Producer는 메세지 큐에 발행한다.
- 큐에는 보통 Consumer, Subscribe가 메세지를 꺼내서 동작을 수행한다.
메세지 큐를 이용하면 서비스 또는 서버 간 결합이 느슨해져서 규모 확장성이 보장되어야 하는 안정적 애플리케이션을 구성하기 좋다.
🚗 로그, 메트릭 그리고 자동화
- 로그: 에러 모니터링을 위해. 로그를 단일 서비스로 모아주는 도구를 활용하면 더 편리하게 검색과 조회가 가능하다.
- 메트릭: 비즈니스 현황의 유용한 정보, 시스템의 현 상태를 파악하기 위함이다.
- 자동화: 시스템이 크고 복잡해지면 생산성과 안정성을 높이기 위해 자동화 도구를 활용해야 한다.
📦 데이터베이스 규모 확장
저장할 데이터가 많아지면 데이터베이스에 대한 부하도 증가
데이터베이서의 규모를 확장하는 2가지 접근법
- 수직적 규모 확장법
- 수평적 규모 확장법
💡 수평적 확장
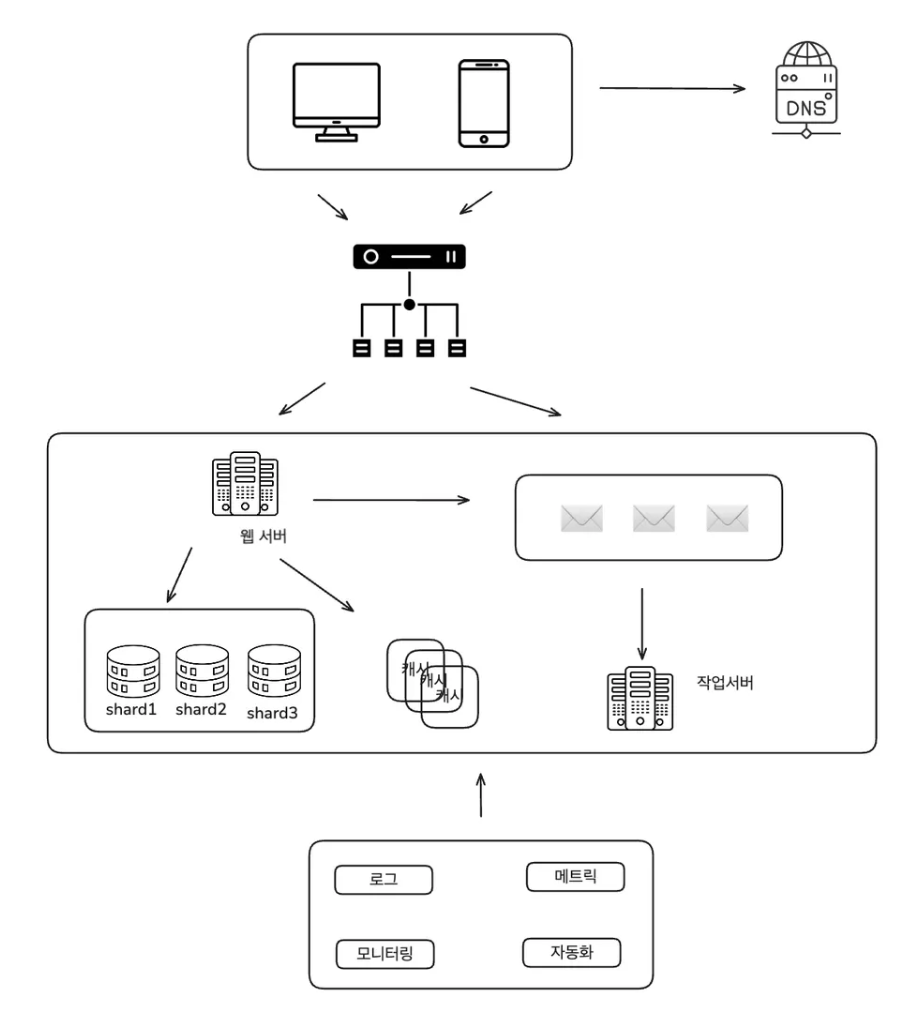
데이터베이스의 수평적 확장은 샤딩 이라 부르는데 더 많은 서버를 추가함으로 성능을 향상시킬 수 있도록 한다.
📖 샤딩
- 대규모 데이터베이스를 샤드 라고 부르는 작은 단위로 분할
- 모든 샤드는 같은 스키마를 사용하지만 보관되는 데이터 사이에 중복이 없다.
⭐ 샤딩 전략을 구현할 때 고려할 가장 중요한 것은 샤딩 키를 어떻게 정하느냐이다.
- 데이터가 어떻게 분산될지 정하는 하나 시아의 컬럼으로 구성
- 샤딩 키를 통해서 데이터 조회나 변경을 처리하므로 효율을 높일 수 있다.
- 데이터를 고르게 분할 할 수 있도록 하는 것이 가장 중요
⚠️ 샤딩에서 고려해야할 조건
1️⃣ 데이터 재 샤딩
- 데이터가 너무 많아져 하나의 샤드로 더 이상 감당하기 어려울 때
- 샤드간 데이터 분포가 균등하지 않을 때
이런 현상들이 발생하면 샤드 키를 계산하는 함수를 변경하고 데이터를 재 배치해야 한다.
2️⃣ 유명인사 문제
특정 샤드에 질의가 집중되어 서버에 과부하가 걸리는 문제
- ex) 저스틴 비버, 레이디 가가 같은 유명인사가 전부 같은 샤드에 저장된 DB가 있을 때 read 연산으로 과부하
3️⃣ 조인과 비정규화
여러 샤드에 걸친 데이터를 조인하기 어려워진다.
- 데이터베이스를 비정규화하여 하나의 테이블에서 질의가 되도록 한다.
🔖 배운 점 정리 및 궁금한 점 정리
🤔 Elastic Load Balancing 은 실제로 어떻게 동작할까?
로드밸런스 부분을 읽으면서 실제로 많이 사용되는 AWS의 Elastic Load Balancing은 어떤 식으로 동작하는지 궁금해져 정리를 해보고자 한다.
1️⃣ 로드 밸런서는 클라이언트에서 오는 트래픽을 허용하고 하나 이상의 가용 영역에서 등록된 대상(예: EC2 인스턴스)으로 요청을 라우팅
2️⃣ 로드 밸런서는 등록된 대상의 상태를 모니터링하고 정상 대상으로만 트래픽이 라우팅
- 로드 밸런서가 비정상인 대상을 감지하면 해당 대상으로 트래픽 라우팅을 중단.
- 이후 해당 대상이 다시 정상으로 감지되면 트래픽을 해당 대상으로 다시 라우팅
3️⃣ 하나 이상의 리스너를 지정하여 들어오는 트래픽을 허용하도록 로드 밸런서를 구성합니다.
- 리스너는 연결 요청을 확인하는 프로세스
- 클라이언트와 로드 밸런서 간의 연결을 위한 프로토콜 및 포트 번호로 구성
- 로드 밸런서와 대상 간의 연결을 위한 프로토콜 및 포트 번호로 구성됩니다.

📔 캐시 전략
이 책에서는 캐시 우선 읽기 전략을 설명해주었는데 다른 전략들에 대해서도 이전에 학습을 했었는데 기억이 잘 안나 한 번 더 확인해보고 정리를 해봐야겠다.
1️⃣ Cache-Aside (Lazy Loading)
- 일반적인 패턴
- 필요한 데이터만 캐싱
2️⃣ Read-Through
- 캐시가 DB 조회를 대신 수행
3️⃣ Write-Through
- 쓰기 시 캐시와 DB에 동시 저장
4️⃣ Write-Behind (Write-Back)
- 캐시에만 쓰고 나중에 DB에 반영
5️⃣ Refresh-Ahead
- 만료 전 미리 갱신
'📕 book > 가상 면접 사례로 배우는 대규모 시스템 설계 기초' 카테고리의 다른 글
[가상면접 사례로 배우는 대규모 시스템 설계 기초] 6장. 키:값 저장소 설계 (1) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 5장. 안정 해시 설계 (0) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 4장. 처리율 제한 장치의 설계 (0) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 3장. 시스템 설계 면접 공략법 (0) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 2장. 개략적인 규모 추정 (0) 2025.12.25