-
벡터화와 임베딩💻 computer science/📦 database 2025. 8. 4. 22:31
컴퓨터는 모든 정보를 0과 1로 구성된 이진수로 표현합니다.
이는 전기 신호의 두 가지 상태, 즉 전류가 흐르거나(
1) 흐르지 않는(0) 상태를 이용한 것입니다.두 가지 상태를 통해 컴퓨터는 방대한 양의 정보를 효율적으로 처리할 수 있습니다.
📌 벡터화 (Vectorization)
우리가 일상생활에서 사용하는 언어(단어, 문장) 또한 0과 1로 이루어진 행렬, 즉 숫자의 집합으로 표현될 수 있습니다.
이렇게 자연어를 컴퓨터가 이해할 수 있는 수치형 데이터인 벡터로 변환해주는 과정을 벡터화(Vectorization) 라고 합니다.
⭐ 벡터화가 필요한 이유
컴퓨터는 텍스트 데이터를 직접 처리할 수 없습니다.
따라서 우리가 사용하는 언어를 컴퓨터가 이해하고 연산할 수 있도록 수치형 데이터인 벡터로 변환하는 과정이 필수적입니다.
🔍 벡터 (Vector)란?
벡터는 여러 개의 숫자를 나열한 것으로 수학적으로는 방향과 크기를 가지고 있는 개념입니다.
자연어 처리에서는 단어나 문장의 특징을 나타내는 숫자들의 배열로 사용됩니다.
📖 벡터화 기법
🔥 One-hot Encoding
가장 단순한 벡터화 기법각 단어를 고유한 인덱스로 변환 후 해당 인덱스에만 1을 부여하고 나머지 인덱스에는 0을 부여하여 벡터를 생성
🔠 예제: “부스트캠프 챌린지 화이팅”
단어 One-hot vector 부스트캠프 [1, 0, 0] 챌린지 [0, 1, 0] 화이팅 [0, 0, 1] ⚠️ One-hot Encoding의 문제
💥 단어 간 의미적인 유사성 반영 불가
"사과"와"배"는 과일이라는 공통점이 있지만 One-hot Encoding으로는 두 단어의 유사성을 파악할 수 없습니다.- 이는 각 단어가 독립적인 차원을 가지기 때문입니다.
💥 차원의 저주 (Curse of Dimensionality)
단어 수가 늘어날수록 벡터의 길이가 단어 수만큼 늘어나게 되어 차원이 너무 커질 수 있습니다.
대부분의 값이 0으로 채워진
희소 벡터(Sparse Vector)를 생성해 공간적 낭비와 연산 효율이 저하🔍 희소 벡터란?
벡터의 값이 대부분 0으로 표현되는 벡터.
- 데이터 저장 공간의 낭비와 연산 시 불필요한 0 연산으로 인한 비효율성 발생.
🔍 벡터의 차원이란?
벡터에 있는 성분(숫자)의 개수, 즉 한 벡터가 몇 개의 숫자로 구성되어 있는지를 의미
- [1, 0, 0, 0, …] (10,000개) ⇒ 10,000차원 벡터
👜 Bag of words (BoW)
문서 내 단어의 빈도(등장 여부 또는 등장 횟수)를 벡터로 나타내는 방법🔠 입력 문장들
문장 1: "부스트캠프 챌린지 화이팅"
문장 2: "부스트캠프 챌린지 성공"
🧾 단어 사전(vocaburary) 만들기 (전체 단어 집합)
[부스트캠프, 챌린지, 화이팅, 성공] ← 전체 문서 기준 단어 모음✅ BoW 벡터
문장 Vector 문장 1 [1, 1, 1, 0] 문장 2 [1, 1, 0, 1] 1은 그 단어가 문장에 존재한다는 뜻- 더 나아가서 횟수를 기록할 수도 있습니다. (예: 단어가 두 번 등장하면 2)
🤔 그럼 One-hot 인코딩에서의 문제였던 유사도 문제를 어떻게 BoW는 해결하지?
BoW는 단어의 빈도를 기준으로 벡터화를 진행하기 때문에 문장 간의 비교가 가능해집니다.
두 문장의 BoW 벡터가 유사하다면 해당 문장들이 유사한 단어 구성(즉, 유사한 내용)을 가질 확률이 높다고 판단할 수 있습니다.
- 문장 간의 유사도를 살펴볼 수 있습니다
📌 DTM (Document-Term Matrix)
BoW를 활용해 여러 문서들을 하나의 행렬로 표현부스트 캠프 챌린지 화이팅 성공 문장 1 1 1 1 0 문장 2 1 1 0 1 - 각 행은 문서, 각 열은 단어
- 각 셀에 들어있는 값은 해당 단어의 등장 횟수
⚠️ DTM의 문제점
문맥 및 단어 간 관계 미반영
- One-hot 인코딩과 마찬가지로 DTM은 문장 내에서 단어 간의 관계를 드러내지 못합니다. 단순히 단어의 빈도만 확인하여 문맥이나 단어의 중요도는 고려하지 않습니다.
차원의 저주 및 희소성
- 단어 수가 많아질수록 벡터 차원이 늘어나 공간적으로 비효율적이고 대부분의 값이 0인 희소 행렬이 되어 연산 효율성이 떨어집니다.
📌 TF-IDF
특정 단어가 문서 내에서 얼마나 중요한지를 나타내는 가중치단순 빈도만 고려하는 BoW의 한계를 보완
📖 용어의 의미
용어 뜻 TF (Term Frequency) 특정 문서에서 해당 단어가 얼마나 자주 나오는지 (단어 빈도) IDF (Inverse Document Frequency) 전체 문서중 이 단어가 얼마나 드문지 (역 문서 빈도) 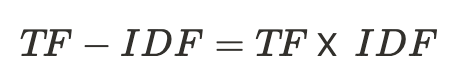
TF-IDF 값이 높다는 것은 특정 문서에서의 빈도수는 높은데 전체 문서에서 등장하는 경우는 적은 것 을 의미- 해당 단어가 특정 문서에서 중요한 의미를 가지는 단어일 가능성이 높다!!!
🆚 BoW vs TF-IDF
항목 BoW TF-IDF 벡터 값 단어 등장 횟수 등장 빈도 × 중요도 공통 단어 많이 나오면 유사도↑ 많이 나와도 중요도 낮아짐 문맥 반영 ❌ 안 됨 ❌ 여전히 안 됨 의미 반영 ❌ 없음 ✅ 어느 정도 반영됨 (빈도 기준) 🚀 임베딩

임베딩은 텍스트(단어, 문장)나 다른 데이터를 컴퓨터가 이해하고 처리할 수 있는 수치형 벡터로 변환하는 과정입니다.- 단순히 데이터를 숫자로 바꾸는 것을 넘어 데이터의 의미와 문맥을 반영하여 비슷한 밀집 벡터 공간에 표현하는 고도화된 벡터화 방법
🔍 밀집 벡터
사용자가 설정한 값으로 모든 단어의 벡터 표현의 차원을 맞춘다.
- 0과 1만 가진 값이 아닌 실수값을 가진다.
🔍 워드 임베딩
단어를 밀집 벡터(Dense Vector)의 형태로 표현하는 방법
- 이런 밀집 벡터를 임베딩 벡터라고 한다.
🧩 임베딩 벡터의 특징
1️⃣ 저차원
- 임베딩 벡터는 일반적으로 100~300 차원과 같이 비교적 낮은 차원으로 구성됩니다.
- 수만 개의 차원을 가질 수 있는 희소 벡터에 비해 훨씬 효율적입니다.
2️⃣ 실수값
- 각 벡터의 성분은 대부분 실수값으로 이루어져 있습니다 (예: 0.42, -0.15, 0.78).
3️⃣ 의미적 유사성 반영
- 벡터 공간에서 유의어나 의미적으로 관련된 단어들은 서로 가깝게 위치합니다.
- 예를 들어 "사과"와 "바나나"는 "자동차"보다 가깝게 위치
4️⃣ 대표적인 워드 임베딩 방법
- Word2Vec, FastText, GloVe 등
'💻 computer science > 📦 database' 카테고리의 다른 글
벡터 유사도 검색 (7) 2025.08.04 Word2Vec (2) 2025.08.04 MySQL - 트랜잭션 격리 수준 실습 (0) 2024.05.11 MySQL - 스토리지 엔진 수준의 락 (0) 2024.05.11 📂 MySQL - 트랜잭션 격리 수준 (0) 2024.05.11