-
벡터 데이터베이스💻 computer science/📦 database 2025. 8. 4. 22:49
🔍 벡터 데이터베이스
벡터 데이터베이스는 벡터 임베딩 을 효율적으로 저장, 인덱싱하고, 이를 기반으로 유사성 검색(Similarity Search) 을 수행하는 데 특화된 데이터베이스입니다.
🤖 벡터 데이터베이스는 어떻게 동작?
기존 데이터베이스는 문자열, 숫자와 같은 스칼라 데이터를 행과 열에 저장합니다.
반면 벡터 데이터베이스는 벡터를 기반으로 작동하기 때문에 최적화 및 쿼리 방식이 다릅니다.
벡터 데이터베이스에서는 유사성 지표를 적용하여 쿼리와 가장 유사한 벡터를 찾습니다.
여러 알고리즘을 사용해 근사 최인접 이웃(ANN) 검색을 수행합니다.
이러한 알고리즘은 쿼리된 벡터의 이웃들을 빠르고 정확하게 검색하는 파이프라인으로 구성됩니다.
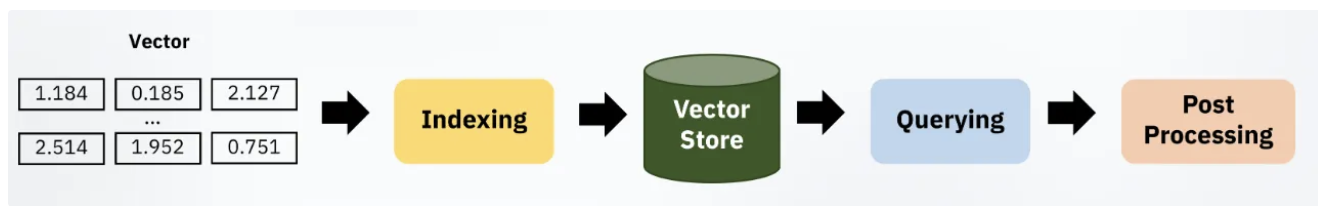
1️⃣ 인덱싱
- 벡터 데이터셋에서 쿼리와 유사한 벡터를 빠르게 찾아내기 위해 데이터를 효율적인 구조로 조직화하는 과정
- 벡터 데이터베이스는 PQ, LSH, HNSW와 같은 다양한 ANN 알고리즘을 사용해 벡터를 인덱싱
2️⃣ 쿼리
- 사용자, 애플리케이션으로부터 받은 쿼리 벡터에 대해 가장 유사한 벡터들을 데이터베이스에서 찾아내는 것
3️⃣ 후처리
- ANN 검색으로 얻은 결과를 정제하고 최종 사용자에게 의미 있는 형태로 반환하는 것
- 필터링이나 우선순위에 따른 정렬등의 작업
🤔 인덱싱 과정이 왜 필요할까?
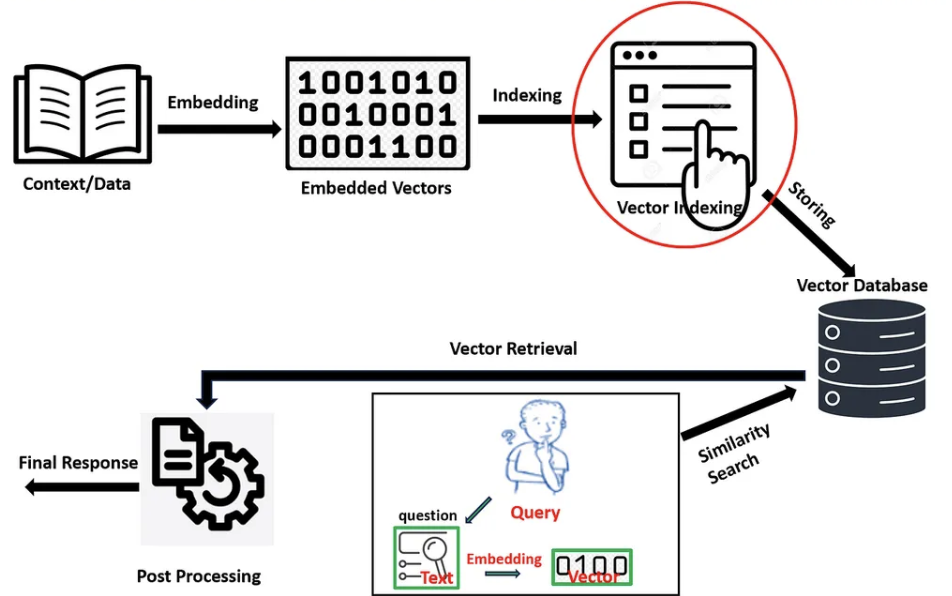
벡터 데이터베이스는 벡터를 색인화하여 유사도 검색의 속도와 효율성을 극대화합니다.
만약 인덱싱이 없다면 쿼리가 들어올 때마다 데이터베이스에 저장된 모든 벡터와 쿼리 벡터를 일일이 비교해야 합니다.
데이터의 양이 적을 때는 문제가 없지만 수백만, 수억 개의 벡터가 저장된 대규모 시스템에서는 이러한 방식으로는 실시간 검색이 불가능해집니다.
인덱싱은 이러한 선형적인 비교를 피하고 미리 구축된 효율적인 데이터 구조를 활용하여 검색 범위를 크게 줄여줍니다.
이를 통해 근사적인 결과일지라도 훨씬 빠르게 찾아낼 수 있게 됩니다.
📖 인덱싱 알고리즘
더 빠른 탐색을 가능하게 하는 자료구조로 벡터를 매핑하는 과정
여러 ANN 알고리즘을 사용합니다.
- 정확한 결과보다 유사한 값들을 검색
1️⃣ Flat Index
벡터를 수정하거나 특별한 복잡한 구조 없이 단순히 저장하는 가장 기본적인 방법
쿼리 시에는 저장된 모든 벡터들과 쿼리 벡터 간의 유사도를 계산해 가장 높은 유사도를 지닌 벡터를 찾는 방법입니다.
🧩 인덱스 생성
- 모든 벡터를 데이터베이스에 추가해 순차적으로 저장
🧩 검색 방식
- 쿼리 벡터가 입력되면 저장된 모든 벡터와 쿼리 벡터간의 유사도를 계산합니다.
- 계산된 유사도 점수를 기준으로 가장 유사한 벡터를 반환합니다.
👍 장단점
장점 단점 100% 정확한 결과 반환 대규모 데이터셋에서는 검색 속도가 매우 느릴 수 있습니다. 모든 벡터를 비교하여 항상 정확히 가장 유사한 벡터를 찾습니다. 메모리 사용량이 단순 저장 방식이므로 높아질 수 있습니다. 2️⃣ Random Projection
고차원 벡터를 저차원 공간으로 투영(Project)해 검색 속도를 빠르게 하는 알고리즘
랜덤하게 생긴 벡터(r)를 만들어 원래 벡터(v)와 내적(v * r)을 합니다.
- 차원이 줄어들지만 원래 벡터 간의 유사성(거리)은 어느 정도 유지됩니다.
- 빠른 탐색이 가능하지만 '근사적'인 값으로 정확도가 떨어질 수 있습니다
3️⃣ Product Quantization
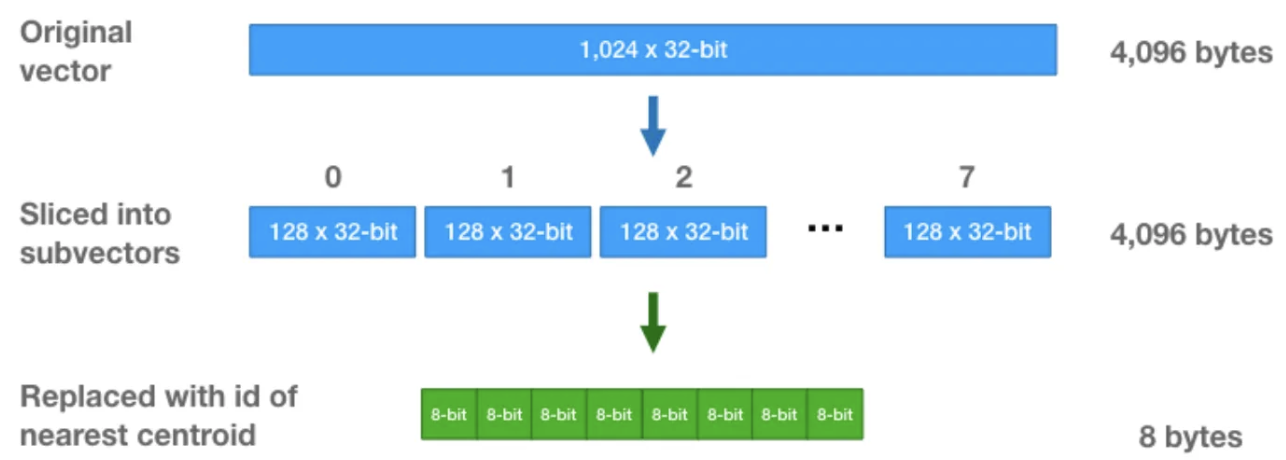
벡터를 여러개의 작은 서브 벡터로 쪼개고 각 서브 벡터을
벡터 양자화를 통해 크기를 줄입니다.- 128차원 벡터 ⇒ 4개의 32차원 벡터로 분할
각 서브 벡터를 미리 정해둔
코드북에서 가장 가까운 값으로 매칭하여 저장검색시 압축된 값만 비교해 빠르게 유사도를 계산
📖 코드북
- 서브 벡터들을 대표하는 기준 벡터들의 집합
- 유사한 벡터를 압축해 표현할 때 참조되는 값들
4️⃣ LSH (Locality-Sensitive Hashing)
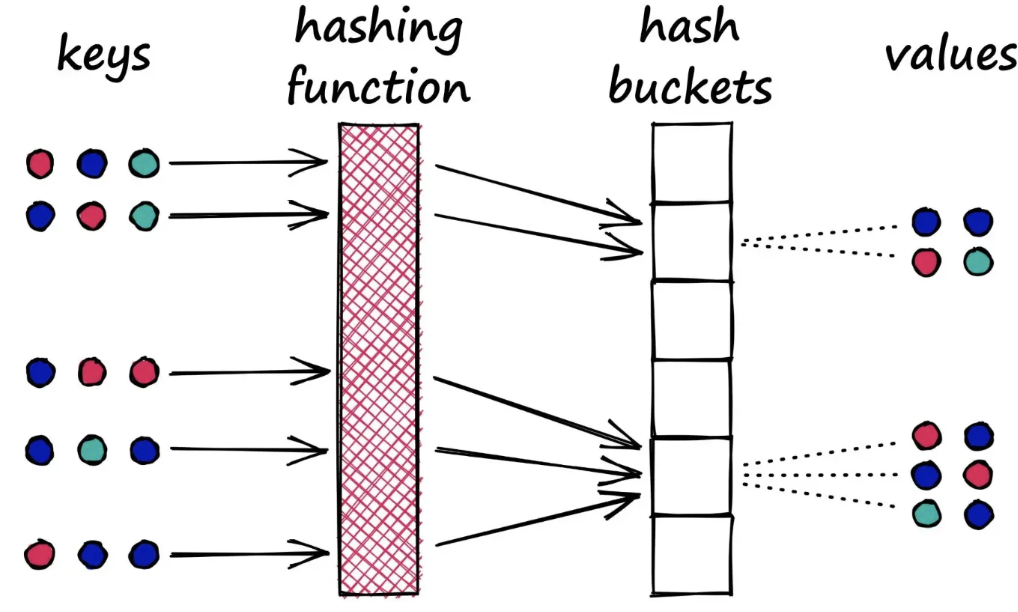
유사한 벡터를 해시함수를 이용해 같은 버킷에 넣는 방식으로 검색 속도를 빠르게 하는 방법
🧩 인덱스 생성
- 데이터 셋의 각 벡터를 해시 함수로 변환해 해시값을 생성하고 해시값을 키로하는 인덱스에 저장
- 동일한 해시값을 가지는 벡터들은 같은 버킷에 저장
🧩 검색
- 쿼리 벡터 입력되면 쿼리 벡터를 해시 함수로 변환하여 해시값을 생성
- 생성된 해시값에 해당하는 버킷을 찾습니다.
- 전체 데이터와 비교하는 것이 아니라 해당 버킷에 있는 데이터들 사이에서만 유사도 비교를 수행하여 가장 유사한 벡터를 찾아 반환합니다.
👍 전체 데이터와 비교하는 것이 아니라 Bucket에 있는 데이터들 사이에서만 찾아 더 빠르게 검색 가능
4️⃣ HNSW (Hierarchical Navigable Small World)
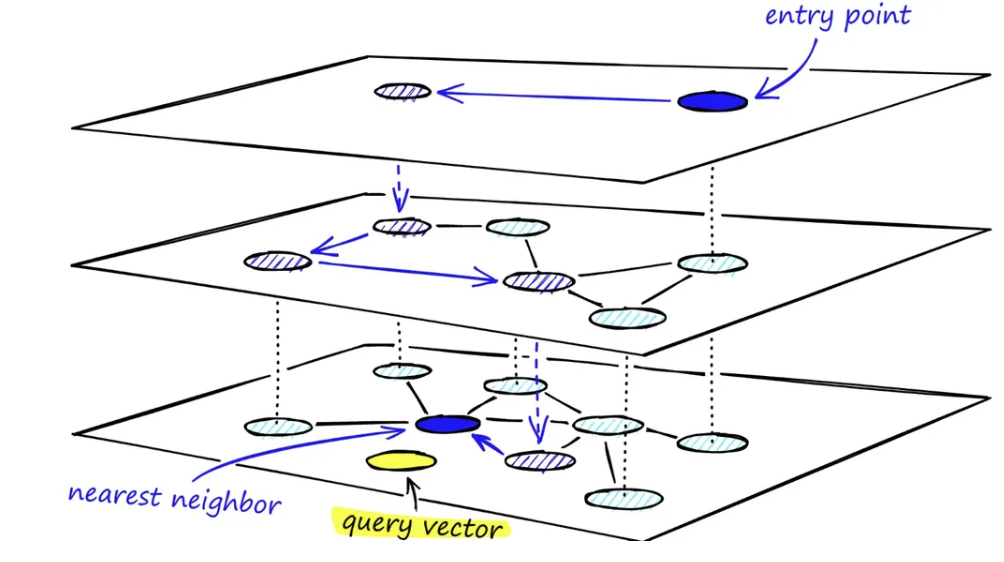
효율적인 검색을 제공하는 그래프 기반 알고리즘주어진 벡터들을 가지고 여러 개의 레이어(계층)를 가진 그래프를 생성합니다.
- 각 벡터 간의 거리는 벡터들 사이의 유사도
🧩 인덱스 생성
- 각 벡터를 그래프의 노드로 추가
- 각 노드는 주변 노드들과 연결. 노드 간의 연결 수 지정
- 탐색 효율성을 높이기 위해 계층적 그래프 구조 생성
🧩 검색
- 쿼리 벡터 입력되면 최상위 레이어의 임의의 노드에서 탐색 시작
- 현재 레이어에서 쿼리 벡터에 가장 가까운 곳으로 이동. 더 가까워질 수 없다면 하위 레이어로 이동
- 모든 벡터가 존재하는 최하위 레이어에 도달할 때까지 반복
- 최하위 레이어에 도달하면 주변 노드들을 추가로 탐색하여 쿼리 벡터와 유사도가 가장 높은 벡터들을 발견후 반환
👍 현재 가장 빠르고 정확한 ANN 알고리즘중 하나로 널리 사용
5️⃣ IVF
대규모 벡터 데이터셋의 검색 효율성을 높이기 위해 데이터를 미리 클러스터링하여 '역파일 인덱스' 구조를 만드는 방법입니다.
🧩 인덱스 생성
- 벡터 데이터셋을 미리 K-means와 같은 군집화 알고리즘을 사용하여 여러 개의
클러스터로 나눕니다. - 각 클러스터의 중심점(센트로이드)을 계산하고 저장합니다.
- 각 벡터는 자신이 속한 클러스터의 '버킷' 또는 '리스트'에 등록됩니다. (마치 텍스트 검색의 역색인처럼 각 센트로이드를 키로 하고 해당 클러스터에 속한 벡터들의 목록을 값으로 가집니다.)
🧩 검색
- 쿼리 벡터가 입력되면 쿼리 벡터와 가장 가까운 몇 개의 센트로이드(nprobe)를 찾습니다.
- 선택된 센트로이드에 해당하는 클러스터 내의 벡터들만을 대상으로 유사도 계산을 수행하여 결과 반환
👍 전체 데이터셋을 탐색하지 않고 관련된 클러스터만 탐색하므로 검색 속도가 빠릅니다.
'💻 computer science > 📦 database' 카테고리의 다른 글
벡터 유사도 검색 (7) 2025.08.04 Word2Vec (2) 2025.08.04 벡터화와 임베딩 (1) 2025.08.04 MySQL - 트랜잭션 격리 수준 실습 (0) 2024.05.11 MySQL - 스토리지 엔진 수준의 락 (0) 2024.05.11