-
벡터 유사도 검색💻 computer science/📦 database 2025. 8. 4. 22:42
⭐ 벡터 유사도 검색
입력으로 주어진 벡터와 유사한 벡터를 데이터베이스에서 빠르게 찾아내는 것을 말합니다.
✅ 벡터 유사도 검색이 필요한 이유
현대의 데이터는 텍스트, 이미지, 음성, 비디오 등 다양한 형태의 비정형 데이터가 대부분.
이런 비정형 데이터는 기존의 관계형 데이터베이스로는 효율적인 검색이 어렵습니다.
벡터 유사도 검색은 이 문제를 해결할 수 있습니다.
예시 - 사용자가 쇼핑몰 검색창에 "맥북 노트북"이라고 입력
- 검색어("맥북 노트북")가 벡터(쿼리 벡터)로 변환
- 벡터 데이터베이스에 저장된 수많은 상품 설명(제품명, 제품 설명 등)들 또한 미리 벡터로 변환되어 있습니다.
- 쿼리 벡터와 데이터베이스에 저장된 상품 설명 벡터들 간의 유사도를 비교합니다.
- 가장 비슷한 벡터들(=가장 관련된 상품들, 예를 들어 'MacBook Pro 16인치' 등)을 찾아 사용자에게 반환하는 방식으로 검색
벡터 유사도 검색은 단순히 키워드 매칭을 넘어 의미론적인 유사성을 기반으로 정보를 찾아내는 것이 가능하게 합니다.
사용자가 입력한 단어들이 정확히 일치하지 않아도 의미적으로 관련된 상품들을 찾아줄 수 있습니다.
🤖 벡터 유사도 검색의 동작 구성 요소
1️⃣ 벡터 임베딩
모든 데이터를 컴퓨터가 이해하고 비교할 수 있는 수치형 벡터(numerical vector)로 변환
- 데이터의 특징과 의미를 함축하고 있는 저차원의 밀집 벡터(Dense Vector)
- 의미적으로 유사한 데이터는 벡터 공간에서 가깝게 위치하고 그렇지 않은 데이터는 멀리 떨어지도록 해 데이터 간의 의미적 또는 기능적 유사성을 벡터 공간에서의 거리나 각도로 표현
- 주요 기술:
Word2Vec
2️⃣ 유사도 점수 계산
두 벡터간의 거리, 방향을 측정해 그 두 벡터가 얼마나 유사한지 유사성 정도를 수치화하는 방법
유사도 점수가 높을수록 두 벡터는 더 유사하며 원본 데이터가 의미적으로 가깝다는 것을 의미
- 주요 계산 방법
- 코사인 유사도
- 유클리디안 거리
3️⃣ 최인접 이웃 알고리즘(NN)
벡터 데이터베이스에서 쿼리 벡터와 가장 유사한 벡터(유사도 점수가 가장 높은 벡터)들을 효율적으로 찾아내는 알고리즘
- 주어진 쿼리 벡터에 대해 벡터 공간 상에서 가장 "가까운" 또는 가장 "유사한" 벡터들을 찾아냅니다.
🤖 유형
- 정확한 최인접 이웃(ENN)
- 데이터베이스의 모든 벡터와 쿼리 벡터를 비교해 정확히 가장 가까운 벡터들을 찾아낸다.
- 항상 최적의 결과를 보장하지만 데이터셋의 크기가 커질수록 계산 비용이 증가(브루트포스)
- 근사 최인접 이웃(ANN)
- 모든 벡터를 비교하는 대신 휴리스틱 또는 인덱싱 구조를 사용해 근사적으로 가장 가까운 벡트들을 빠르게 찾아낸다.
- 대규모 데이터셋에서 빠른 검색 속도를 제공
- 최적의 결과를 보장하지는 않아 정확도 손실이 있을 수 있다.
🔍 벡터 유사도 측정 방법
두 벡터 간의 "거리" 또는 "방향"을 측정하여 그 유사성 정도를 수치화하는 방법
1️⃣ 코사인 유사도 (Cosine Similarity)
- 벡터 간의 방향을 기준으로 유사도를 측정
- 벡터의 크기(길이)에는 영향을 받지 않음.
- 두 벡터의 내적을 벡터 크기의 곱으로 나눈 값
- 값의 범위:
-1~1(1에 가까울수록 유사) - 주요 사용 분야: NLP (자연어 처리) 분야에서 텍스트 데이터의 의미적 유사성 검색
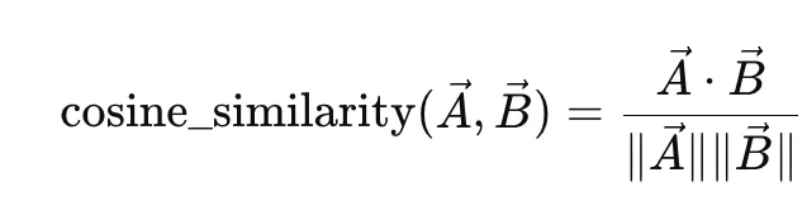
🤔 왜 텍스트 데이터의 의미적 유사성 검색에 사용?
단어나 문장의 길이가 길어져 벡터의 크기가 커지더라도 중요한 것은 단어들이 표현하는 의미적 방향입니다.
코사인 유사도는 이러한 방향의 유사성만을 독립적으로 측정하므로, 텍스트의 의미적 유사성을 파악하는 데 매우 적합.
예시
"나는 오늘 점심에 국수를 먹었다." "나는 점심으로 국수 먹었어."- 둘의 문장 길이는 다르지만 의미는 거의 같습니다.
이 문장들을 임베딩을 한 후 벡터로 만든다면
const a = [0.3, 0.7, 0.1]; // 예시 const b = [0.6, 1.4, 0.2]; // b = a * 2 코사인 유사도 = 1.0 (완벽히 같은 방향)- 즉, 크기가 달라도 “방향이 같다면” 의미가 같은 것으로 봅니다.
2️⃣ 유클리디안 거리 (Euclidean Distance)
- 두 벡터 공간상의 직선 거리를 계산
- 0부터 무한대까지, 값이 작을수록 더 유사 (0에 가까울 수록)
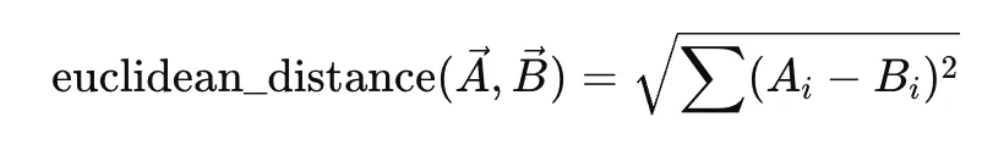
📌 차원이 커지면 거리 계산이 왜곡되는 경우가 많아 고차원에서는 덜 선호
3️⃣ 맨하탄 거리 (Manhattan Distance)
- 축을 따라 직각으로만 이동한 거리의 총합
- 도시의 블록을 이동하는 것과 같다고 하여 "택시거리(Taxicab Distance)”라고도 불림
- 0부터 무한대까지, 값이 0에 가까울수록 더 유사
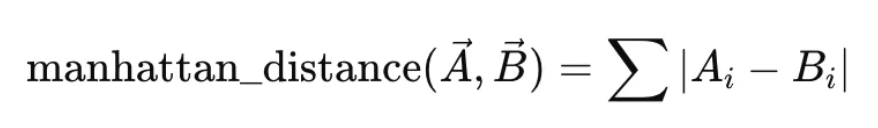
📊 정리
측정 방법 특징 유사한 경우 값 Cosine 유사도 방향 기반 유사도 측정 1에 가까움 Euclidean 거리 직선 거리 기반 거리 측정 0에 가까움 Manhattan 거리 축을 따라 이동한 총 거리 0에 가까움
📌 KNN 알고리즘 (K-Nearest Neighbors)KNN은 벡터 유사도 검색의 최인접 이웃(NN) 알고리즘에 속합니다.
📖 의미
K-Nearest Neighbors는 "K개의 가장 가까운 이웃"을 의미합니다.
쿼리 벡터가 주어졌을 때 이 데이터 포인트와 가장 유사한(가장 가까운) K개의 기존 데이터 포인트를 찾아내는 알고리즘입니다.
🏃 동작 방식
- 거리 계산: 쿼리 벡터와 데이터셋 내의 모든 기존 벡터들 간의 유사도(또는 거리)를 계산합니다.
- 이때 유클리디안 거리, 코사인 유사도 등 위에서 언급된 유사도 측정 방법을 사용
- K개 선택: 계산된 유사도를 기준으로 가장 유사하거나 가까운 K개 데이터 벡터를 선택.
- 결과 결정: 선택된 K개의 이웃들의 속성을 바탕으로 최종 예측을 수행
✅ 벡터 유사도 검색에서의 KNN
벡터 유사도 검색의 관점에서 KNN은 쿼리에 대해 데이터베이스에서 가장 유사한 K개의 결과를 찾는 기본 로직을 제공합니다.
대규모 벡터 데이터베이스에서는 모든 벡터와 일일이 비교하는 KNN의 무차별 대입(Brute-force) 방식은 비효율적
이러한 문제를 해결하기 위해 실제로 벡터 데이터베이스에서는 KNN의 개념을 기반으로 하는 근사 최인접 이웃(ANN) 알고리즘
예: HNSW, LSH, IVF)을 사용하여 훨씬 빠르게 유사한 K개의 이웃을 찾아냅니다.
즉, ANN은 KNN 검색의 효율적인 구현을 위한 기술!!!
'💻 computer science > 📦 database' 카테고리의 다른 글
벡터 데이터베이스 (2) 2025.08.04 Word2Vec (2) 2025.08.04 벡터화와 임베딩 (1) 2025.08.04 MySQL - 트랜잭션 격리 수준 실습 (0) 2024.05.11 MySQL - 스토리지 엔진 수준의 락 (0) 2024.05.11