-
[가상면접 사례로 배우는 대규모 시스템 설계 기초] 6장. 키:값 저장소 설계📕 book/가상 면접 사례로 배우는 대규모 시스템 설계 기초 2025. 12. 25. 14:19
키-값 저장소는 키-값 데이터베이스라고도 불리는 비 관계형 데이터베이스
- 저장되는 값은 고유 식별자를 키로 가지고 각 값은 키를 통해서만 접근이 가능하다.
- 키는 일반 텍스트일 수도 있고 해시 값일 수도 있다.
- 키는 짧을수록 좋다.
🤖 키-값 저장소 예시
- Amazon Dynamo
- Memcached
- Redis
🎯 이번 챕터에서 설계한 키-값 저장소 특성
- 키-값 쌍의 크기는 10KB 이하이다.
- 큰 데이터를 저장할 수 있어야 한다.
- 높은 가용성을 제공해야 한다.
- 장애가 있더라도 빨리 응답해야 한다.
- 높은 규모 확장성을 제공해야 한다.
- 트래픽 양에 따라 자동적으로 서버 증설 및 삭제가 이루어져야 한다.
- 데이터 일관성 수준은 조정이 가능해야 한다.
- 응답 지연시간(latency)이 짧아야 한다.
💻 단일 서버 키-값 저장소
한 대 서버만 사용하는 키-값 저장소를 설계하는 가장 직관적인 방법은
키-값쌍 전부를 메모리에 해시 테이블로 저장하는 것이다.- 빠른 속도를 보장하지만 모든 데이터를 메모리 안에 두는 것이 불가능할 수도 있다는 한계가 존재.
문제를 해결하기 위한 개선책
- 데이터 압축
- 자주 쓰이는 데이터만 메모리에 두고 나머지는 디스크에 저장
🚗 분산 키-값 저장소
분산 키-값 저장소는 분산 해시 테이블이라고 불린다.
- 키-값 쌍을 여러 서버에 분산
분산 시스템을 설계할 때는
CAP 이론을 이해하고 있어야 한다.💡 CAP 이론 (Consistency, Availability, Partition Tolerance theorem)
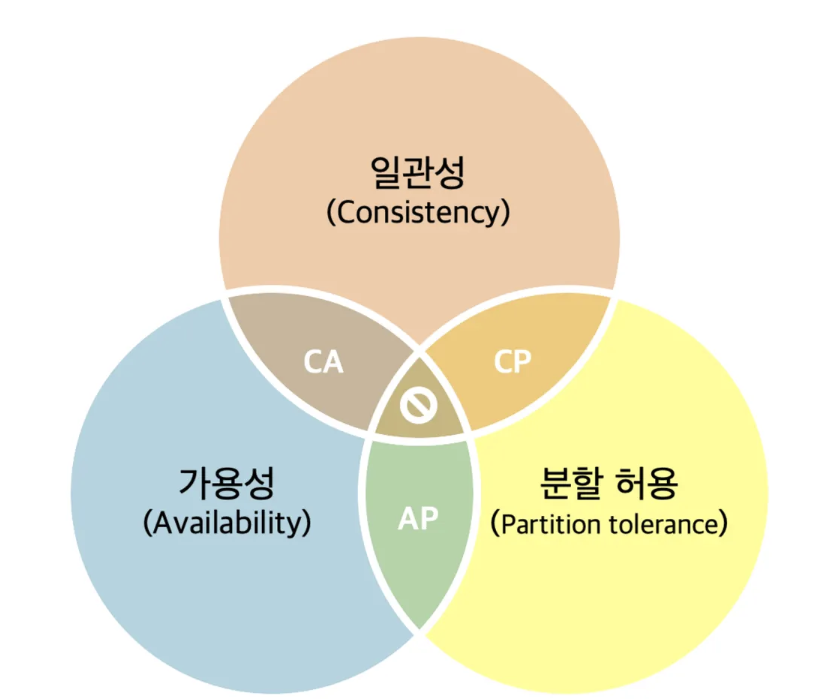
https://javacatcher.tistory.com/226?category=1275585 데이터 일관성, 가용성, 파티션 감내 라는 세 가지 요구사항을 동시에 만족하는 분산 시스템을 설계하는 것은 불가능하다.
📖 CAP 이론 3가지 요소
데이터 일관성(Consistency) 모든 클라이언트는 어떤 노드에 접속했는에 상관없이 언제나 같은 데이터를 조회 가용성 (Availability) 일부 노드에 장애가 발생하더라도 항상 응답을 받을 수 있어야 함. 파티션 감내 (Partition tolerance) 네트워크에 파티션이 생기더라도 시스템은 계속 동작해야 함 - 파티션: 두 노드 사이에 통신 장애가 발생했다는 것을 의미
✅ 세 가지 모두를 동시에 만족할 수는 없으며 파티션 감내는 반드시 필요
- 실제 구현시에는
CP또는AP둘 중 하나를 선택한다.
🧑🏻💻 CAP 시스템 종류
CP 시스템 일관성과 파티션 감내를 지원 (가용성을 희생) 은행 서비스 같은 일관성이 중요한 경우 AP 시스템 가용성과 파티션 감내를 지원 (일관성 희생) SNS, 캐시 등에서 사용 CA 시스템 일관성과 가용성을 지원 ❌ 실제 CA 시스템은 존재하지 않음. - 네트워크 장애는 피할 수 없는 일이므로 분산 시스템에서는 파티션 문제를 반드시 감내가 되도록 설계가 되어야 한다.
👀 예시 - 이상적 상태
분산 시스템에서 데이터는 보통 여러 노드에 복제되어 보관된다.
세 대의 복제노드(replica) n1, n2, n3에 데이터를 복제하여 보관하는 상황을 가정.

이상적인 환경에서는 네트워크가 파티션이 되는 상황은 일어나지 않는다.
- n1에 기록된 데이터는 자동으로 n2, n3에 복제
- 따라서 일관성과 가용성도 만족한다.
👀 예시 - 실제 분산 시스템
분산 시스템은 파티션 문제를 피할 수 없다.
- 파티션 문제가 발생하면 일관성과 가용성 사이에서 하나를 선택해야 한다.
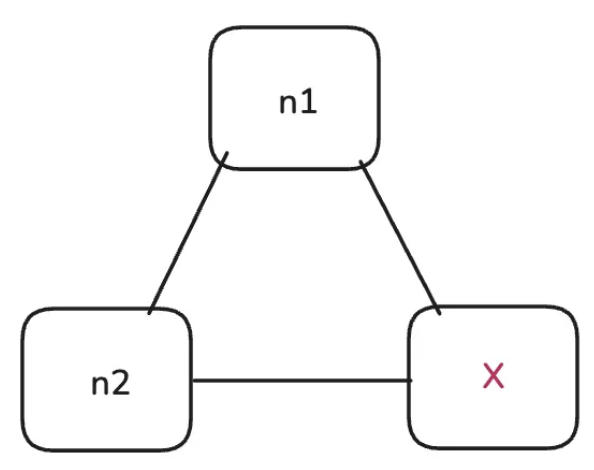
n3에 장애가 발생하여n1,n2와 통신할 수 없는 상황- 클라이언트가 n1 또는 n2 에 데이터를 기록했다면 이 데이터는 n3에 전달되지 않는다.
- n3에 데이터가 기록이 되었지만 n1, n2로 전달되지 않은 데이터가 있다면 n1과 n2는 계속해서 이를 모르고 오래된 정보를 가지고 있을 것이다.
☑️ 일관성을 선택한 경우 -
CP위 예제에서 3개의 서버사이에 생길 수 있는 데이터 불일치 문제를 피하기 위해 n1, n2에 대해 쓰기 연산을 중단해야 한다.
- 이렇게 되면 가용성이 깨지게 된다.
🏦 온라인 뱅킹 시스템
- 계좌 최신 정보를 전달하지 않으면 큰 문제일 것이다.
- 파티션때문에 일관성이 깨지게 되면 해당 서비스는 해결될 때까지 오류를 반환
☑️ 가용성을 선택한 경우 -
AP낡은 데이터를 반환하는 문제가 있더라도 계속 읽기 연산을 허용해주어야 한다.
- n3에 문제가 생긴 경우라도 n1, n2는 계속 쓰기 연산을 허용하고 파티션 문제가 해결된 이후 n3에 새로운 데이터 정보를 전송해준다.
💡 정리
따라서 분산 키-값 저장소를 만들 때는 요구사항에 맞게
CAP 정리를 적용해야 한다.🤖 시스템 컴포넌트
키-값 저장소구현에 사용하는 핵심 컴포넌트 및 기술들- 데이터 파티션
- 데이터 다중화 (replication)
- 일관성
- 일관성 불일치 해소
- 장애 처리
- 시스템 아키텍처 다이어그램
- 쓰기 경로
- 읽기 경로
👾 데이터 파티션
대규모 애플리케이션 상황에서 전체 데이터를 하나의 서버에 넣는 것을 불가능
- 데이터를 작은 파티션들로 분할하여 여러 대 서버에 저장
🤔 데이터를 파티션 단위로 나눌 때 고려해야할 문제
- 데이터를 여러 서버에 고르게 분산할 수 있나
- 노드가 추가, 삭제될 때 데이터의 이동을 최소화할 수 있나
💡 5장에서의
안정 해시를 이용하면 적합👋 안정 해시를 사용해 데이터를 파티션했을 때의 장점
- 규모 확장 자동화
- 시스템 부하에 따라 서버가 자동으로 추가 또는 삭제되도록 할 수 있다.
- 다양성
- 각 서버의 용량에 맞게 가상 노드의 수를 조정할 수 있다.
- 고성능의 서버는 많은 가상 노드를 갖도록 설정가능
🖐️ 데이터 다중화
높은 가용성, 안정성을 위해서 데이터를 N개의 서버에 비동기적으로 다중화해주어야 한다.
- 일반적으로 해시 링에서 시계방향으로 순회하면서 만나는 첫 N개의 서버에 데이터 사본을 저장
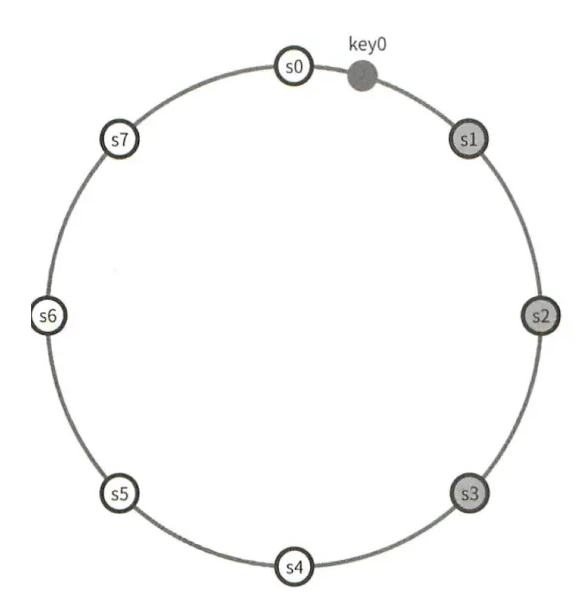
⚠️ 가상 노드를 사용한다면 선택한 N개의 노드가 대응될 실제 물리 서버의 개수가 N보다 작아질 수 있다.
- 이 문제를 피하기 위해서는 노드 선택 시 같은 물리 서버를 중복 선택하지 않도록 해야 한다.
🤔 무슨 의미이지?
예시:
s0, s1, s2가 모두 서버 A 한 대에 있는 가상 노드들일 수 있다.N = 3일 때 key 0의 다중화된 데이터들이 물리적으로 같은 서버인 A에 모두 저장된다.문제 설명 서버 장애 서버 하나에 장애가 발생시 key의 복제본이 함께 손실 고가용성 불가 정전, 네트워크 이슈, 자연 재해등의 문제를 함께 겪어 대응이 불가 복제 의미가 없어짐 논리적으로는 3개의 노드에 저장, 물리적으로는 1개의 서버에 몰려 있어 복제 의미가 없어짐. ↔️ 데이터 일관성
여러 노드에 데이터가 다중화되었다면 데이터들은 동기화가 되어야 한다.
💡 정족수 합의 (Quorum Consensus) 프로토콜을 사용하면 읽기 / 쓰기 연산에 모두 일관성을 보장할 수 있다.
📖 정족수 합의
📖 정족수
- 회의나 의결을 진행하기 위해 필요한 최소한의 참석 인원 수
- 분산 시스템에서는 어떤 연산을 성공으로 간주하기 위해 필요한 최소한의 응답 수
🤖 정의
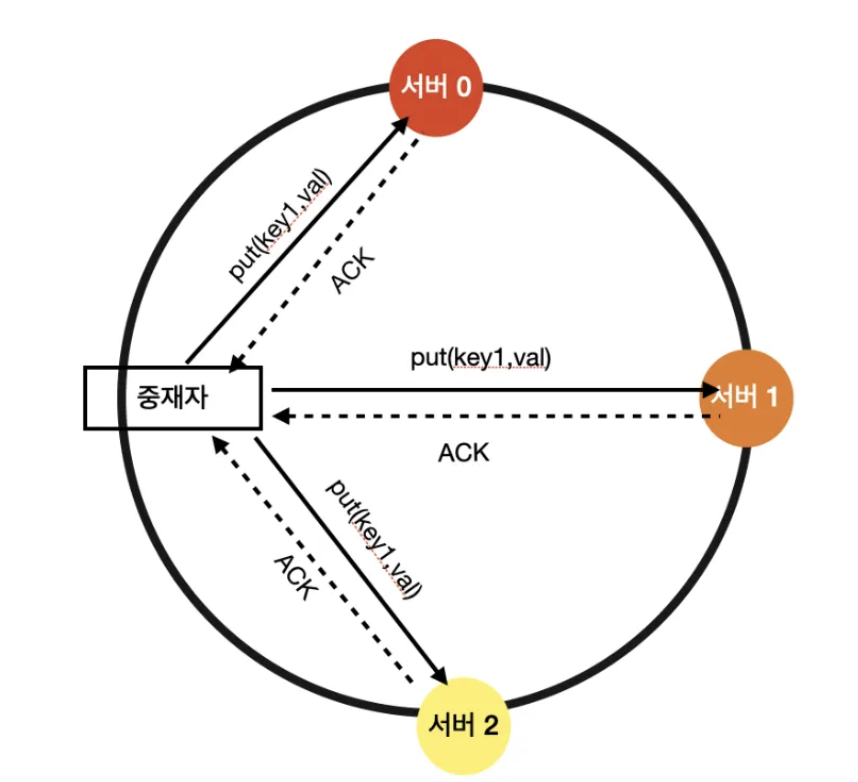
N 사본 개수 W 쓰기 연산에 대한 정족수 쓰기 연산이 성공으로 간주되기 위해서는 적어도 W개의 서버로부터 쓰기 연산이 성공했다는 응답을 받아야 함. R 읽기 연산에 대한 정족수 읽기 연산이 성공으로 간주되기 위해서는 적어도 R개의 서버로부터 읽기 연산이 성공했다는 응답을 받아야 함. 👀 예시: N - 3
1️⃣
W=1데이터가 한 대 서버에만 기록된다는 뜻이 아니다.
데이터가 서버0, 서버1, 서버2에 다중화가 된 상태
W=1의 의미는 쓰기 연산이 성공했다고 판단하기 위해서 중재자(coordinator) 는 최소 한 대 서버로부터 쓰기 성공 응답을 받아야 한다는 의미.- 서버1로 부터 성공 응답을 받았다면 서버0, 서버2의 응답을 기다릴 필요가 없다.
📖 중재자 역할
- 클라이언트와 노드 사이의 프락시(proxy) 역할
2️⃣
W=1또는R=1중재자는 한 대 서버로부터의 응답만 받으면 된다 → 응답속도가 빠르다.
W또는 R의 값이 1보다 큰 경우에는 데이터 일관성의 수준을 향상되지만 중재자의 응답 속도는 가장 느린 서버로부터 오는 응답을 기다려야 하기 때문에 느려질 것이다.
3️⃣
W + R > N강한 일관성을 보장할 수 있다.
- 일관성을 보증할 최신 데이터를 가진 노드가 최소 하나는 겹치기 때문.
💡 몇 가지 구성
R=1,W=N: 빠른 읽기 연산에 최적화된 시스템W=1,R=N: 빠른 쓰기 연산에 최적화된 시스템W+R > N: 강한 일관성이 보장W+R < N: 강한 일관성이 보장되지 않음.
☑️ 일관성 모델
일관성 모델은 데이터 일관성의 수준을 결정.
🤖 종류
- 종류가 다양하다.
강한 일관성 모든 읽기 연산은 항상 최신 결과를 반환 약한 일관성 읽기 연산은 최신 결과를 반환하지 않을 수 있다. 결과적 일관성 약한 일관성의 한 형태. 결국에는 모든 사본이 동기화된다. 강한 일관성
- 모든 사본에 현재의 쓰기 연산의 결과가 반영될 때 까지 해당 데이터에 대한 읽기, 쓰기를 금지
- 고가용성 시스템에 적합하지 않음(새로운 요청의 처리가 중단되기 때문)
다이나모 또는 카산드라 같은 저장소는 결과적 일관성 모델을 선택하고 있다.
결과적 일관성 모델을 따르면 쓰기 연산이 병렬적으로 발생하면 일관성이 깨질 수 있다.
이 문제는 클라이언트가 해결해야 한다.
👀 비 일관성 해소 기법: 데이터 버저닝
클라이언트 측에서 데이터의 버전 정보를 활용해 일관성이 깨진 데이터를 읽지 않도록 하는 기법
데이터를 다중화하게 되면 가용성은 높아지고 사본간 일관성은 깨질 가능성이 높아진다.
버저닝(versioning)과벡터 시계(vector clock)는 그 문제를 해소하기 위해 등장한 기술이다.
📖 버저닝
- 데이터를 변경할 때마다 해당 데이터의 새로운 버전을 만드는 것
- 각 버전의 데이터는 변경이 불가능하다.
💥 데이터 일관성이 깨지는 예시
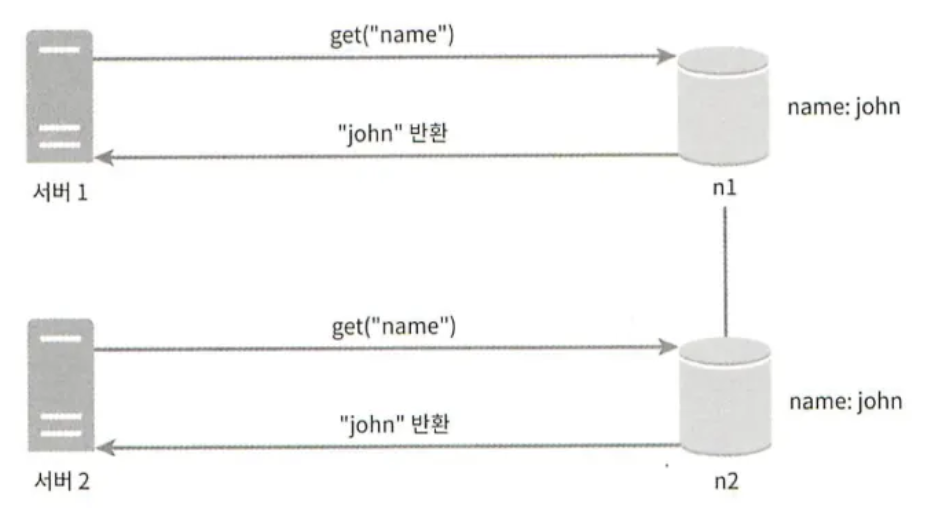
- 데이터의 사본이 노드1, 노드2에 저장되어 있는 상황
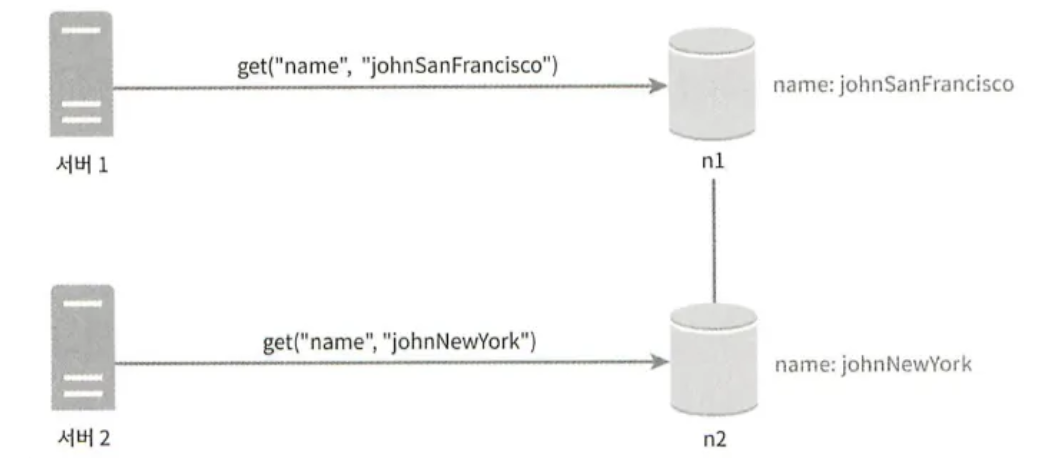
서버1은 값을 johnSanFrancisco로 변경하고 서버2는 johnNewYork으로 변경.
이 두 연산이 동시에 이루어진다고 한다면 충돌하는 두개의 값을 가지게 되었다.
벡터 시계는 이 문제를 해결하는데 사용되는 기술이다.
🕣 벡터 시계 (vector clock)
[서버, 버전]의 순서쌍을 데이터에 매단 것.- 데이터를 서버에 기록할 때 해당 서버의 버전을 증가
- 이를 통해 어떤 버전이 선행 버전인지, 후행 버전인지 다른 버전과 충돌이 있는지 판별한다.
벡터 시계 수행 예시
D([S1, v1], [S2, v2], …., [Sn, vn])같이 표현한다고 가정D: 데이터vi: 버전 카운터 값Si: 서버 번호
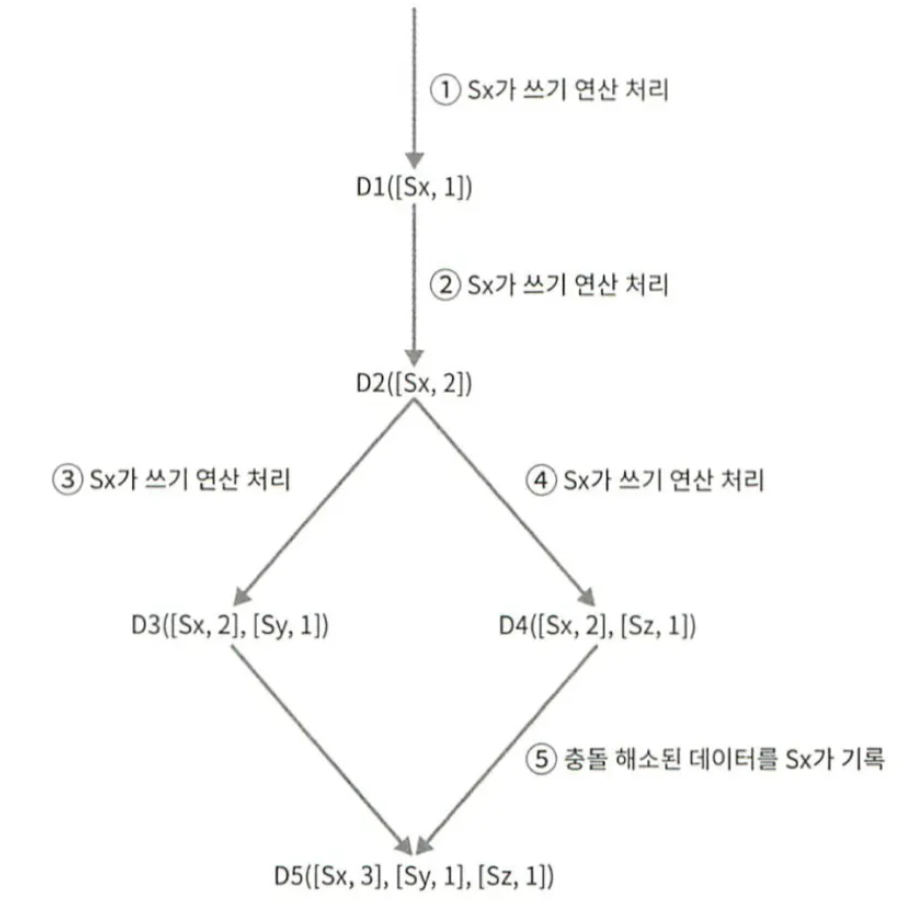
1️⃣ 클라이언트가 데이터
D1을 기록- 쓰기 연산을 처리해주는 서버:
Sx - 벡터 시계:
D1([Sx, 1])
2️⃣ 다른 클라이언트가 D1을 읽고
D2로 업데이트 후 기록- D2는 D1에 대한 변경이므로 D1을 덮어쓴다
- 쓰기 연산을 처리해주는 서버:
Sx - 벡터 시계:
D2([Sx, 2])
3️⃣ 다른 클라이언트가 D2를 읽어
D3로 업데이트 후 기록- 쓰기 연산을 처리해주는 서버:
Sy - 벡터 시계:
D3([Sx, 2], [Sy, 1])
4️⃣ 또 다른 클라이언트가 D2를 읽어
D4로 업데이트 후 기록- 쓰기 연산을 처리해주는 서버:
Sz - 벡터 시계:
D4([Sx, 2], [Sz, 1])
5️⃣ 어떤 클라이언트가 D3와 D4를 읽으면 데이터간 충돌이 있다는 것을 알게 된다.
- 이 충돌을 클라이언트가 해소한 후 서버에 기록한다.
- 쓰기 연산을 처리해주는 서버:
Sx - 벡터 시계:
D5([Sx, 2], [Sy, 1], [Sz, 1])
😎 벡터 시계를 사용하면 어떤 버전 X가 버전 Y의 이전 버전인지 쉽게 판단할 수 있다.
- 충돌이 없는지 확인
- 버전 Y에 포함된 모든 구성요소의 값이 X에 포함된 모든 구성요소 값보다 같거나 큰지만 확인
⚠️ 벡터 시계 단점
1️⃣ 충돌 감지 및 해소 로직이 클라이언트에게 들어가야해 클라이언트 구현이 복잡해진다.
2️⃣
[서버:버전]의 순서쌍 개수가 빠르게 늘어나게 된다.- 임계치를 설정한 후 임계치 이상으로 길어지면 오래된 순서쌍을 제거
- 이럴 경우 버전 간 선후 관계가 정확하지 않을 수 있어서 효율성이 낮아질 수 있다.
💡 다이나모 DB에 관계된 문헌에 따르면 아마존은 실제 서비스에서 그런 문제가 벌어지는 것을 발견한 적이 없다고 한다.
💣 장애 처리
장애는 대규모 시스템에서 아주 흔하게 발생한다.
따라서 장애를 어떻게 처리하느냐는 굉장히 중요한 문제이다.
✔️ 장애 감지
분산 시스템에서는 한 대 서버가 “서버 A가 지금 죽었습니다”라고 판단한다고 서버 A를 장애처리 하지 않는다.
- 보통 두 대 이상의 서버가 똑같이 서버 A의 장애를 보고해야 실제로 장애가 발생했다고 간주
👾 간단한 방법: 모든 노드 사이에 멀티캐스팅 채널을 구축
- 서버가 많을 때는 비효율적이다.
📌 분산형 장애 감지 솔루션 (decentralized failure detection)
가십 프로토콜(gossip protocol)같은 분산형 장애 감지 솔루션을 채택하는 것이 효율적이다.🏃 가십 프로토콜 동작 원리
- 각 노드는 멤버십 목록을 유지
- 각 멤버 ID와 그 박동 카운터(heartbeat counter)쌍의 목록
- 각 노드는 주기적으로 자신의 박동 카운터를 증가
- 각 노드는 무작위로 선정된 노드들에게 주기적으로 자기 박동 카운터 목록을 보낸다.
- 박동 카운터 목록을 받은 노드는 멤버십 목록을 최신 값으로 갱신한다.
- 어떤 멤버의 박동 카운터 값이 지정된 시간 동안 갱신되지 않는다면 해당 멤버는 장애 상태인 것으로 간주한다.
🧹 장애 처리
📍 일시적 장애 처리
가십 프로토콜로 장애를 감지한 시스템은 가용성을 보장하기 위해서 조치를 해야 한다.
- 엄격한 정족수 방식 - 일관성을 보장하기 위해 읽기 / 쓰기 연산을 중단
- 느슨한 정족수 방식 - 장애 상태 서버를 제외하고 쓰기 연산을 할 W개의 서버와 읽기 연산을 수행할 R개의 서버를 해시 링에서 선택하여 처리한다.
장애 상태인 서버로 가는 요청은 다른 서버가 잠시 맡아서 처리한 후 그동안 발생한 변경사항은 해당 서버가 복구되었을 때 일괄적으로 반영하여 데이터 일관성을 보존한다.
- 이를 위해 임시로 쓰기 연산을 처리한 서버에는 그에 대한 단서(hint)를 남겨둔다.
- 이런 장애 처리 방안을 단서 후 임시 위탁(hinted handoff) 기법이라 부른다.
📍 영구 장애 처리
일시적 장애와 달리 영구적인 서버 장애를 처리하기 위해서 반-엔트로피(anti-entropy) 프로토콜을 구현해 사본들을 동기화한다.
- 사본들을 비교하여 최신 버전으로 갱신(동기화)
- 사본 간의 일관성 상태를 탐지하고 전송 데이터의 양을 줄이기 위해 머클(Merkle) 트리를 사용한다.
📖 머클 트리
- 해시 트리라고도 불린다.
- 각 노드에 그 자식 노드들에 보관된 값의 해시 또는 자식 노드들의 레이블로부터 계산된 해시 값을 레이블로 붙여두는 트리
해시 트리를 사용하면 대규모 자료구조의 내용을 효과적이면서도 보안상 안전한 방법으로 검증할 수 있다.
- 리프 노드(Leaf Node): 실제 데이터 블록 (예: 데이터 청크, 파일 조각)
- 부모 노드(Parent Node): 자식 노드들의 해시를 결합하여 생성한 새로운 해시
- 루트 해시(Root Hash): 전체 트리의 최상단에서 모든 데이터를 대표하는 단 하나의 해시
📍 작동 방식
- 각 데이터 블록에 해시 함수를 적용 → 리프 노드 해시 생성
- 인접한 두 리프 해시를 합친 후 다시 해시 함수 적용 → 부모 노드 해시 생성
- 이 과정을 반복하여 최종 루트 해시에 도달
👀 예시 - 상황 설정
3개의 복제 서버가 있다고 가정
- 서버 A (Primary)
- 서버 B (Replica 1)
- 서버 C (Replica 2) ← 영구 장애 복구
저장된 데이터: 4개의 버킷
- Bucket 1: "User Data A" →
Hash: 2a4f - Bucket 2: "User Data B" →
Hash: 5c8e - Bucket 3: "User Data C" →
Hash: 7d2b - Bucket 4: "User Data D" →
Hash: 9f1a
🍃 각 서버의 머클 트리 구성
서버 A(정상)
Level 2:          Root: 4x2a
                   /       \
Level 1:      Hash1: 8c9d   Hash2: 3e4f
              /    \        /    \
Level 0:   2a4f   5c8e   7d2b   9f1a
            ↓      ↓       ↓      ↓
         Bucket  Bucket  Bucket  Bucket
           1      2       3       4
서버 C (장애 후 복구, 데이터 손상)
Level 2:          Root: 7x3c  ← 다름!
                   /       \
Level 1:      Hash1: 8c9d   Hash2: 2a1b  ← 다름!
              /    \        /    \
Level 0:   2a4f   5c8e   9g3c   9f1a  ← Block 3 손상
            ↓      ↓      ↓      ↓
          Bucket  Bucket  Bucket  Bucket
            1      2      3      4
👾 반-엔트로피 프로토콜 실행
🆚 루트 레벨 비교
- 서버 A: "루트 해시: 4x2a"
- 서버 C: "루트 해시: 7x3c"
결과: 루트가 다르다 → 데이터 불일치 감지! 🚨
⚠️ 문제점 (머클 트리 없는 경우)
- 모든 4개 블록의 원본 데이터를 네트워크로 전송해야 함
- 불필요한 데이터 전송 발생
👍 머클 트리의 이점 (계층적 비교)
계층적으로 비교 시작
- 서버 A의
Hash1: 8c9dvs 서버 C의Hash1: 8c9d→ 일치! ✅- Bucket 1, 2는 정상
- 서버 A의
Hash2: 3e4fvs 서버 C의Hash2: 2a1b→ 불일치! ❌- Bucket 3, 4 중 하나 이상에 문제
마지막: Level 0, 손상된 부분만 비교
- Bucket 3:
7d2b(A) vs9g3c(C) → 불일치 ❌ → Bucket 3만 전송 - Bucket 4:
9f1a(A) vs9f1a(C) → 일치! ✅
☑️ 최소한의 데이터 전송
초기 상태
- 전체 데이터: 4개 블록
동기화 과정
✅ Bucket 1: 전송 불필요 (해시 일치)
✅ Bucket 2: 전송 불필요 (해시 일치)
❌ Bucket 3: 전송 필요 (해시 불일치)
✅ Bucket 4: 전송 불필요 (해시 일치)
결과: 총 4개 중 1개만 전송 (75% 대역폭 절감)
다른 데이터를 갖는 버킷을 찾아 그 버킷들만 동기화하면 된다!!
🏭 데이터 센터 장애 처리
정전, 네트워크 장애, 자연재해 등 다양한 이유로 데이터 센터 장애가 발생할 수 있다.
- 데이터를 여러 데이터 센터에 다중화되어야 한다.
- 하나의 센터가 망가져도 다른 데이터 센터에 보관된 데이터를 이용
🖌️ 시스템 아키텍처 다이어그램
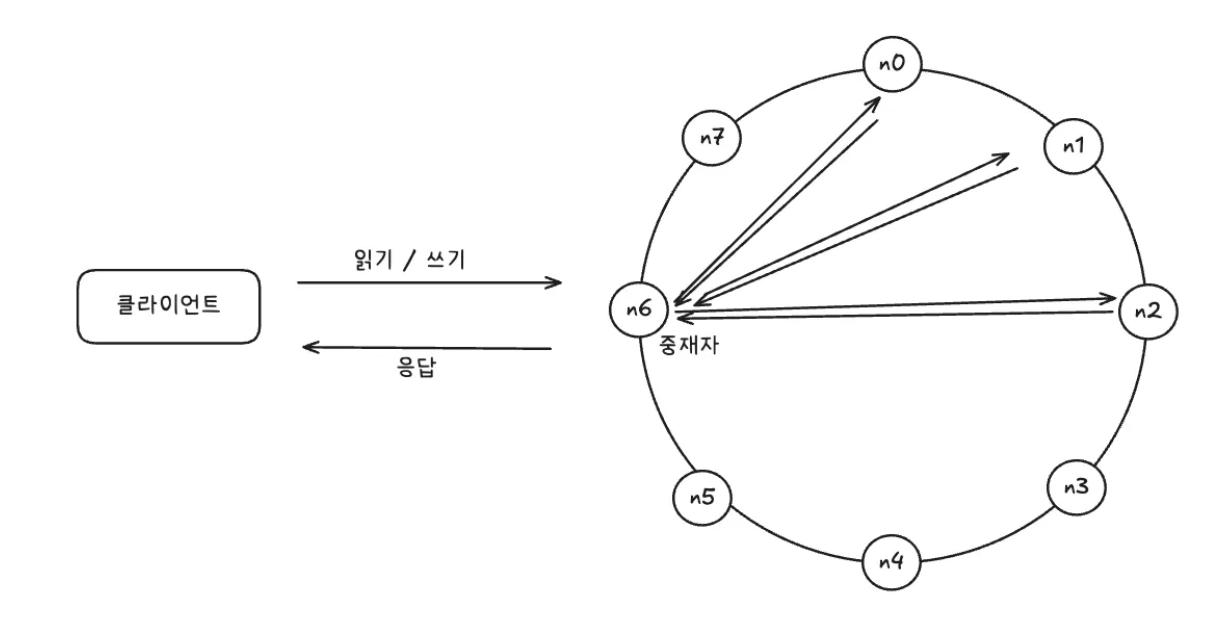
💡 아키텍처의 주된 기능
- 클라이언트는 키-값 저장소가 제공하는 API(get, put)를 통해 통신
- 중재자는 클라이언트에게 키-값 저장소에 대한 프록시 역할 수행
- 노드는 안정 해시의 해시 링 위에 분포
- 노드는 자동으로 추가 / 삭제할 수 있도록 시스템은 완전히 분산
- 데이터는 여러 노드에 다중화된다.
- 모든 노드가 같은 책임을 가져
SPOF(단일 장애점)가 존재하지 않는다.
✍️ 쓰기 요청
쓰기 요청이 특정 노드에 전달되었을 때 발생하는 일
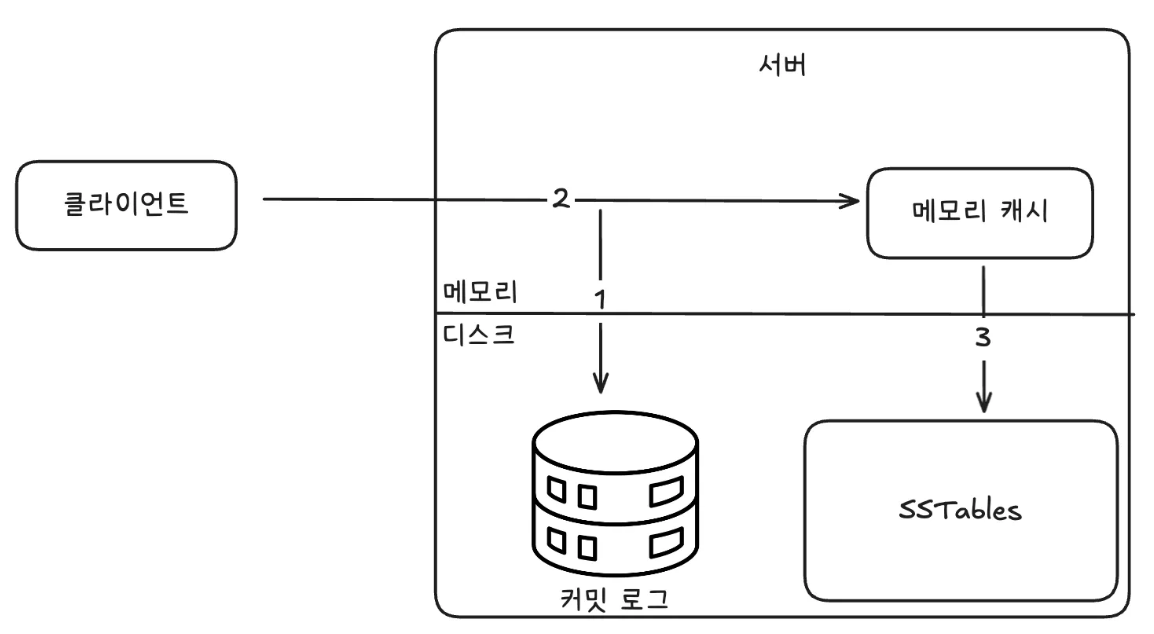
- 쓰기 요청이 커밋 로그 파일에 기록
- 데이터가 메모리 캐시에 기록
- 메모리 캐시가 가득차거나 임계치에 도달하면 데이터는 디스크에 있는
SSTable에 기록
📖 SSTable
- Sorted-String Table
- (키, 값) 순서쌍을 정렬된 리스트 형태로 관리하는 테이블
🙄 읽기 요청
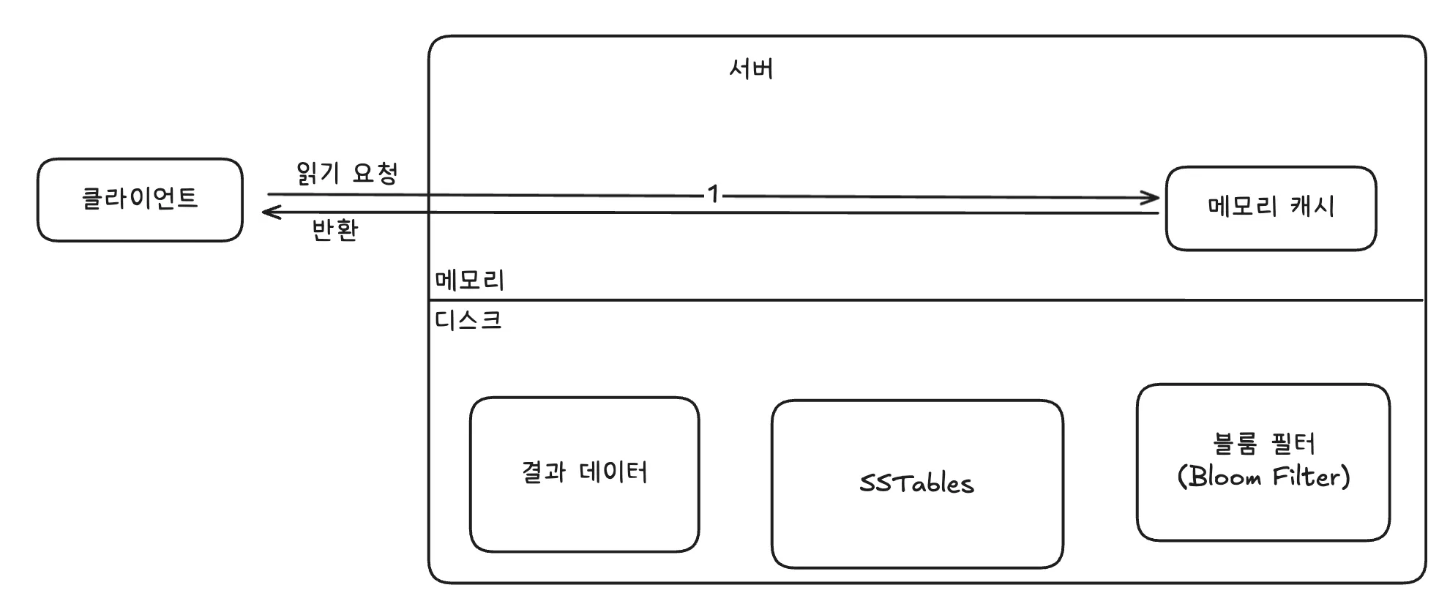
- 읽기 요청을 받은 노드는 데이터가 메모리 캐시에 있는지 확인
- 있는 경우 데이터를 클라이언트에 반환
- 데이터가 메모리에 없다면 블룸 필터를 검사
- 블룸 필터를 통해 어떤
SSTable에 키가 보관되어 있는지 알아낸다.
- 블룸 필터를 통해 어떤
SSTable에서 데이터를 가져온다.- 데이터를 클라이언트에게 반환
데이터가 메모리에 없는 경우에는 디스크에서 데이터를 가져와야 하는데 어느 SSTable에 찾는 키가 있는지 알아낼 수 있는 효율적인 방법이 필요하다.
- 이런 문제를 풀기 위해 블룸 필터가 흔히 사용된다.
🔍 블룸 필터
- 키가 존재할 가능성을 빠르게 판단하는 확률적 자료구조.
- 존재하지 않는 경우에는 100% 정확하지만 존재할 경우 오탐이 가능
'📕 book > 가상 면접 사례로 배우는 대규모 시스템 설계 기초' 카테고리의 다른 글
[가상면접 사례로 배우는 대규모 시스템 설계 기초] 8장. URL 단축기 설계 (0) 2026.01.04 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 7장. 분산 시스템을 위한 유일 ID 생성기 설계 (0) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 5장. 안정 해시 설계 (0) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 4장. 처리율 제한 장치의 설계 (0) 2025.12.25 [가상면접 사례로 배우는 대규모 시스템 설계 기초] 3장. 시스템 설계 면접 공략법 (0) 2025.12.25